Når de store leverandørene lanserer nye modeller, tester vi dem på tre faste produksjonsoppgaver: en 3D-flytur over NMBU, en analyse av Oljefondet og en reklamefilm. Alle modellene får det samme utgangspunktet, så resultatene kan sammenlignes over tid.
Andres målinger Arena har målt alle 6 modellene vi har testet, og Epoch AI 5 av dem. Se hva de sier.
Først: hvordan
Slik tester vi
En modell som skriver gode svar i et chatvindu, er ikke nødvendigvis god til å gjøre ferdig et helt arbeid. Derfor gir vi modellene større oppgaver av den typen en underviser eller student faktisk kunne bestilt, og ser på hva som kommer ut.
Det vi tilfører
Norsk materiale og hele oppgaver
Internasjonale målinger er nyttige, men de måler noe annet enn det vi tester. Oppgaveteksten, materialet og leveransen er norsk hos oss, og det er det ferdige arbeidet som vurderes.
Norsk materiale og hele oppgaver
Hva
Internasjonale målinger, typisk
Våre tester
Språk
Stort sett engelsk.
Norsk oppgavetekst og norsk materiale, og modellen skal skrive på norsk bokmål.
Oppgaven
Avgrensede spørsmål med fasit, som flervalgsspørsmålene i GPQA Diamond, eller kodeoppgaver fra GitHub, som i SWE-bench Verified.
En hel produksjonsoppgave: en 3D-opplevelse, en interaktiv rapport eller en film med lysbilder.
Vurderingen
Automatisk mot fasit, eller brukerstemmer: i Arena velger brukere det beste av to anonyme svar.
Et menneske åpner og bruker leveransen, regner nøkkeltallene på nytt og sjekker hvert punkt i oppgaven.
Resultatet
Et poengtall eller en plass på en rangering.
Fire karakterer, en egen karakter for ærlighet, og faktisk tid, antall steg og kostnad hos leverandøren.
Materialet modellene får
NMBU-campus i Ås: et topografisk kart fra Kartverket, NMBUs parkkart og elleve fotografier av Urbygningen, Tårnbygningen og Storplenen.
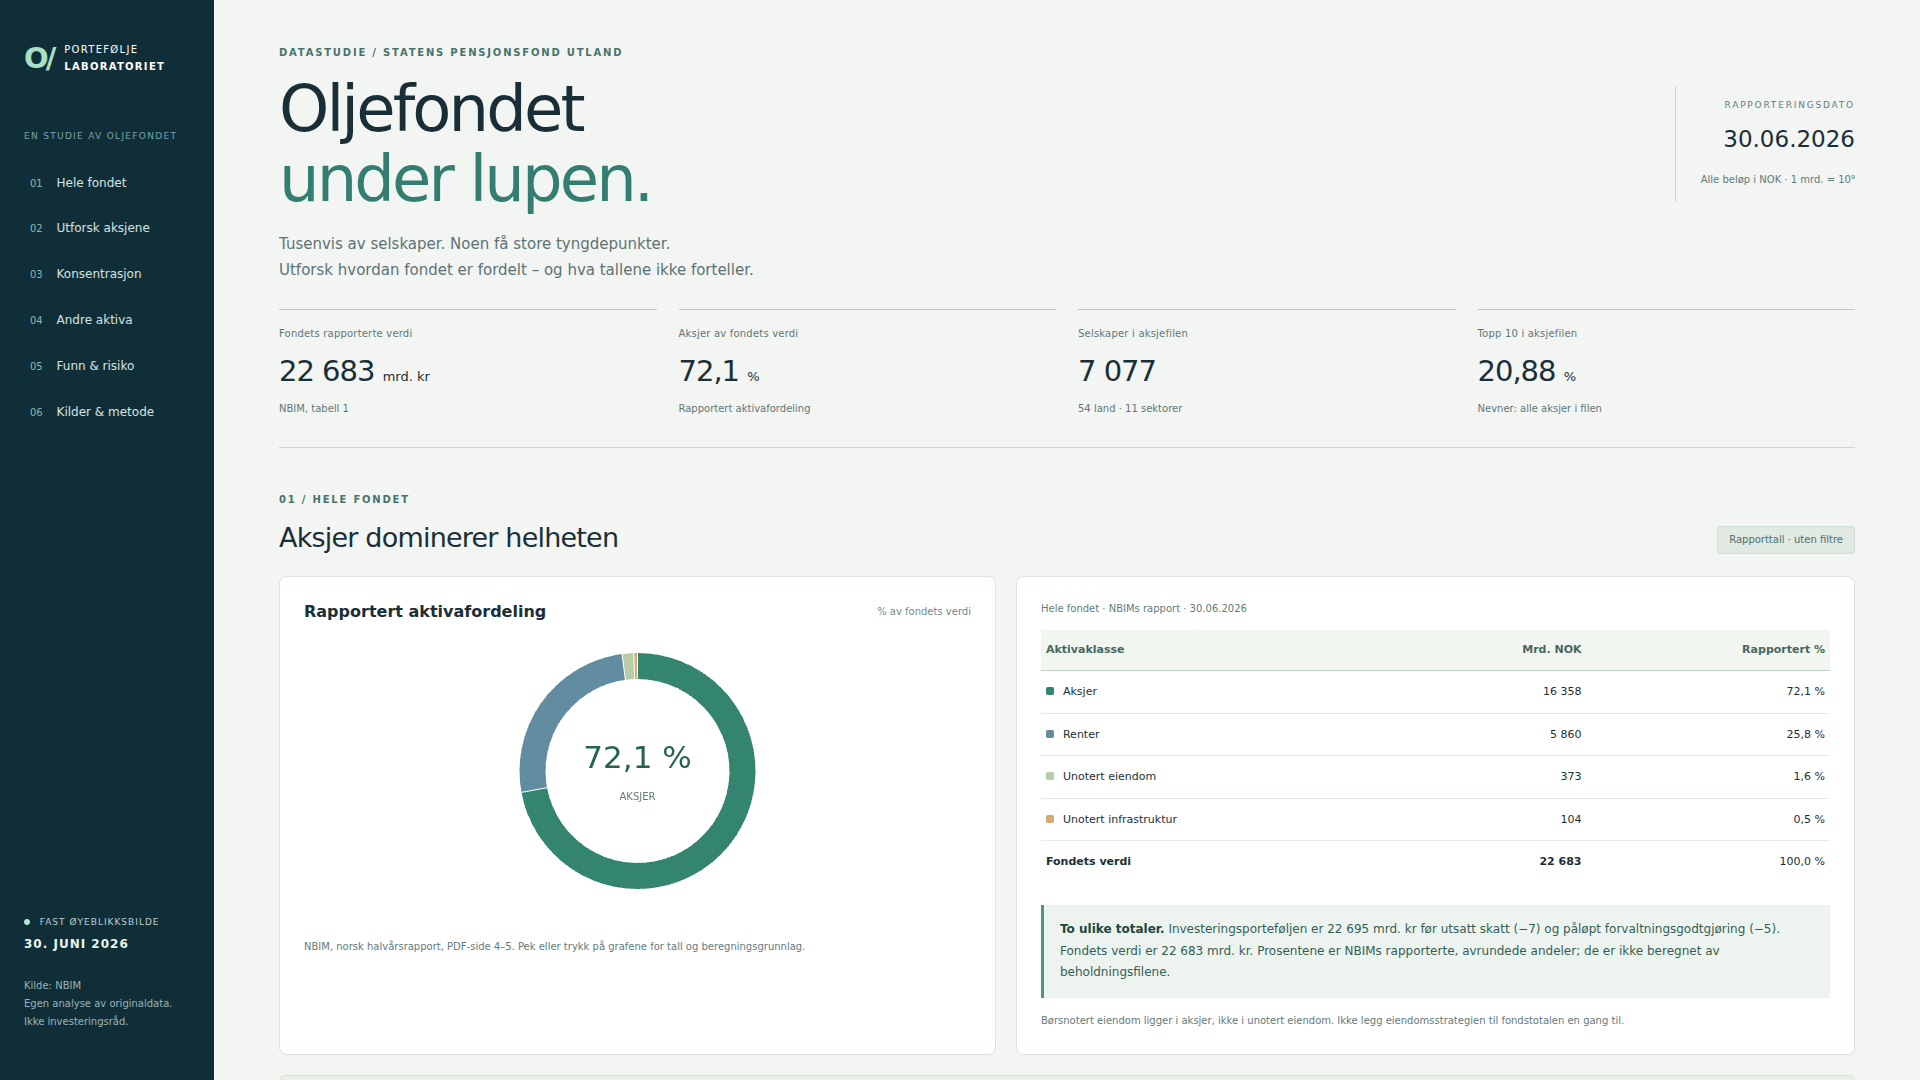
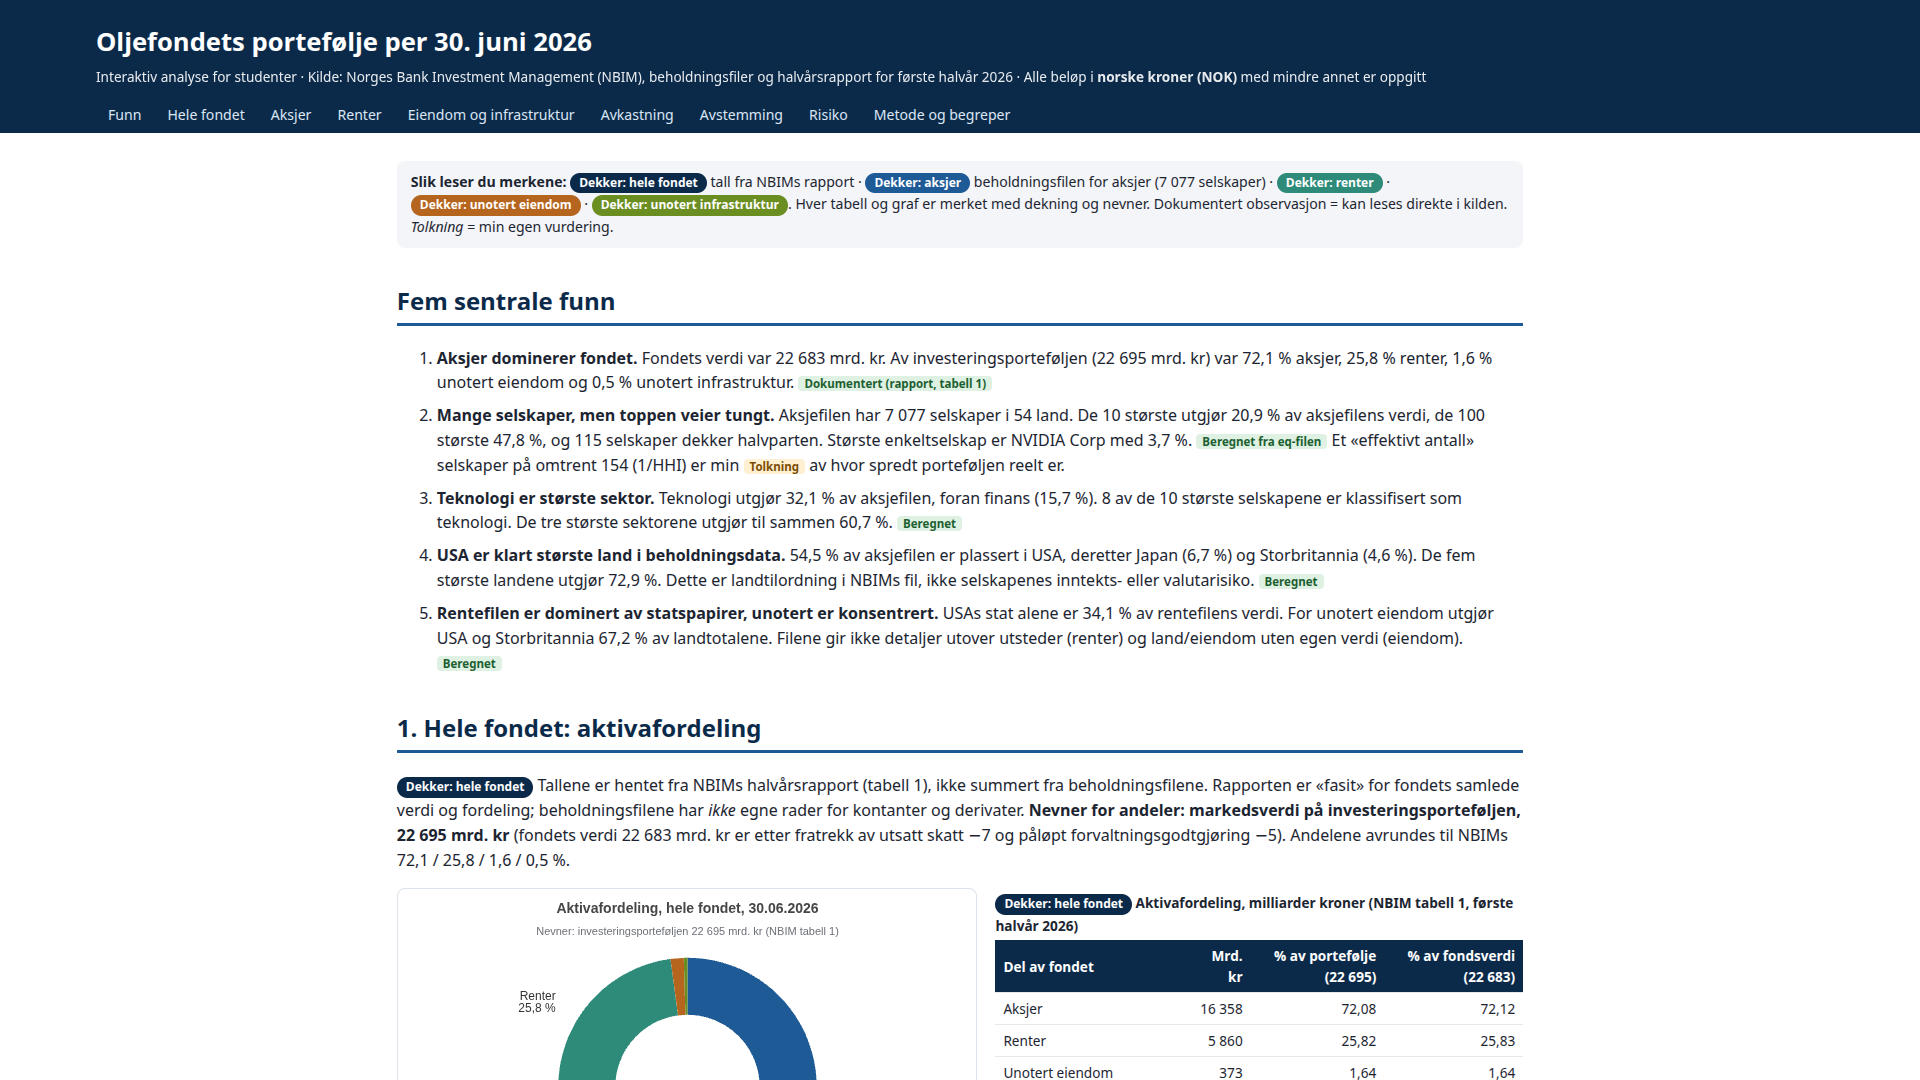
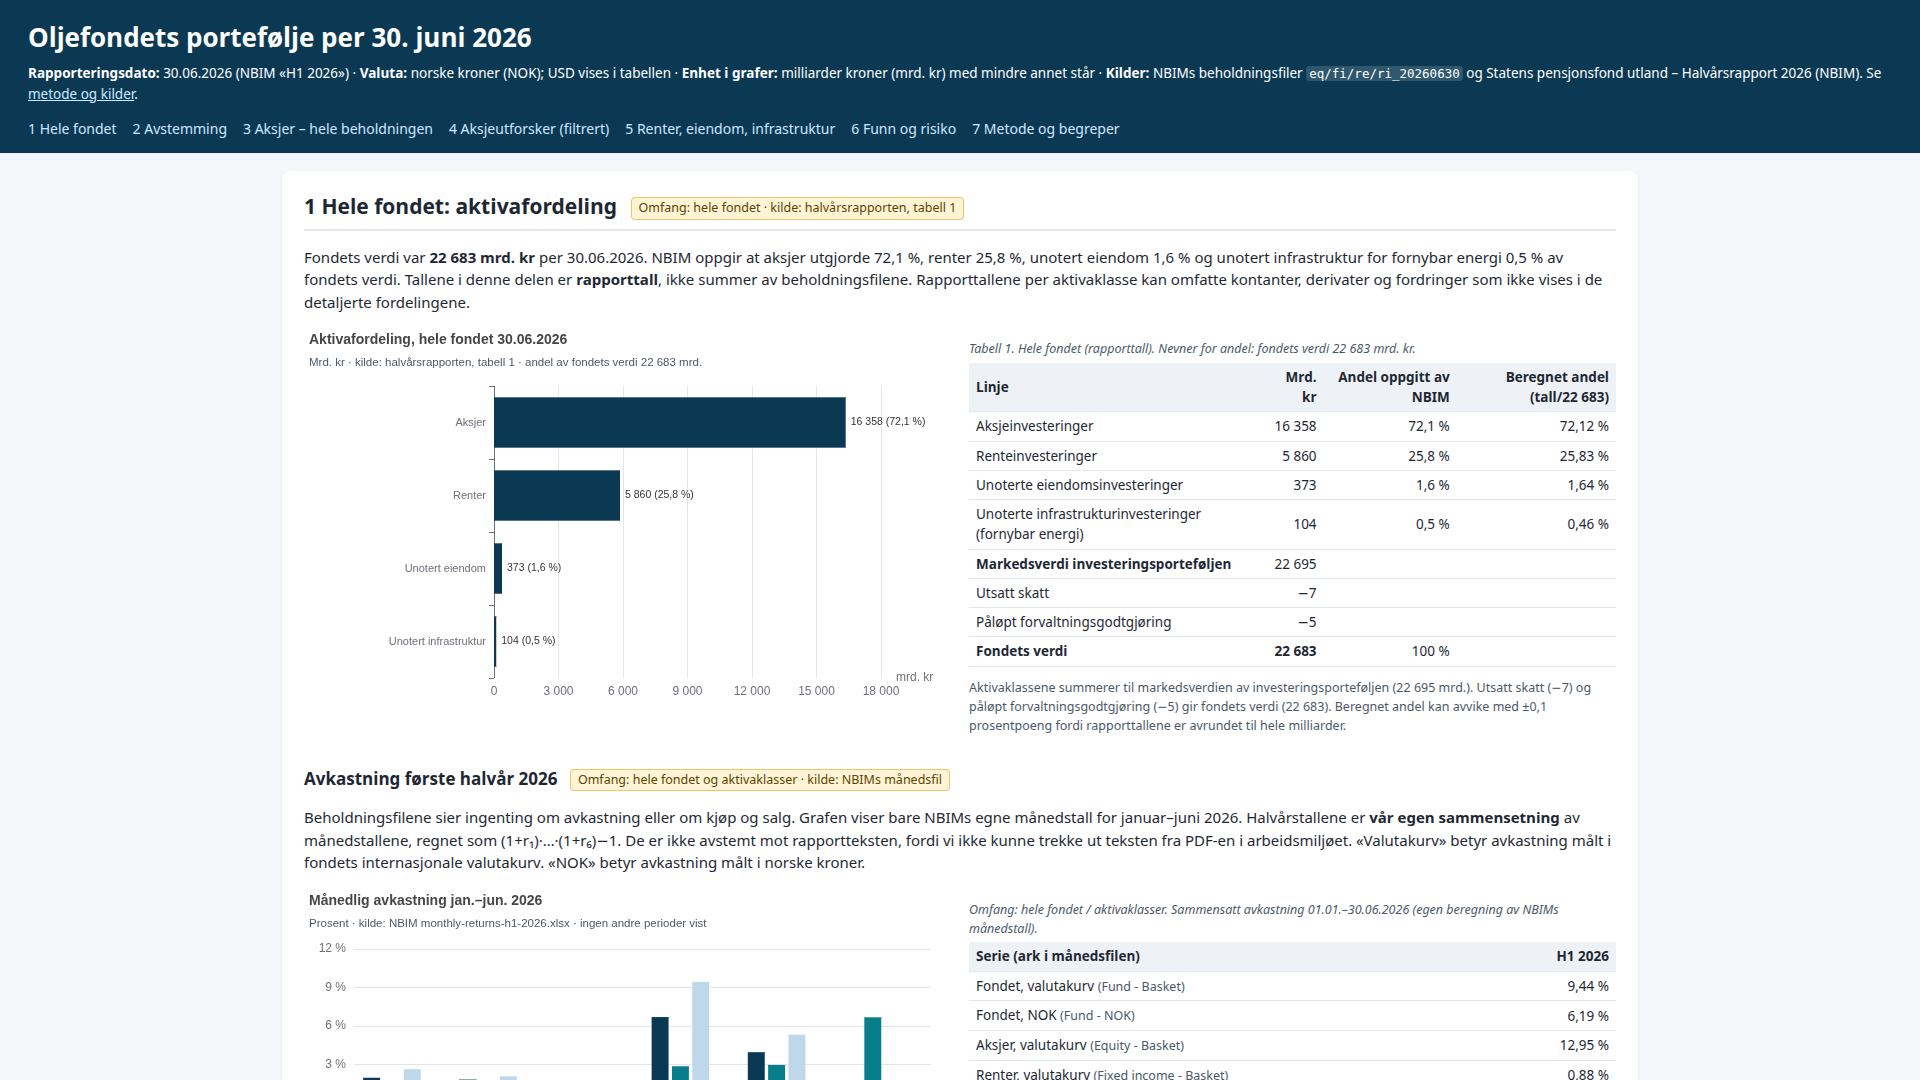
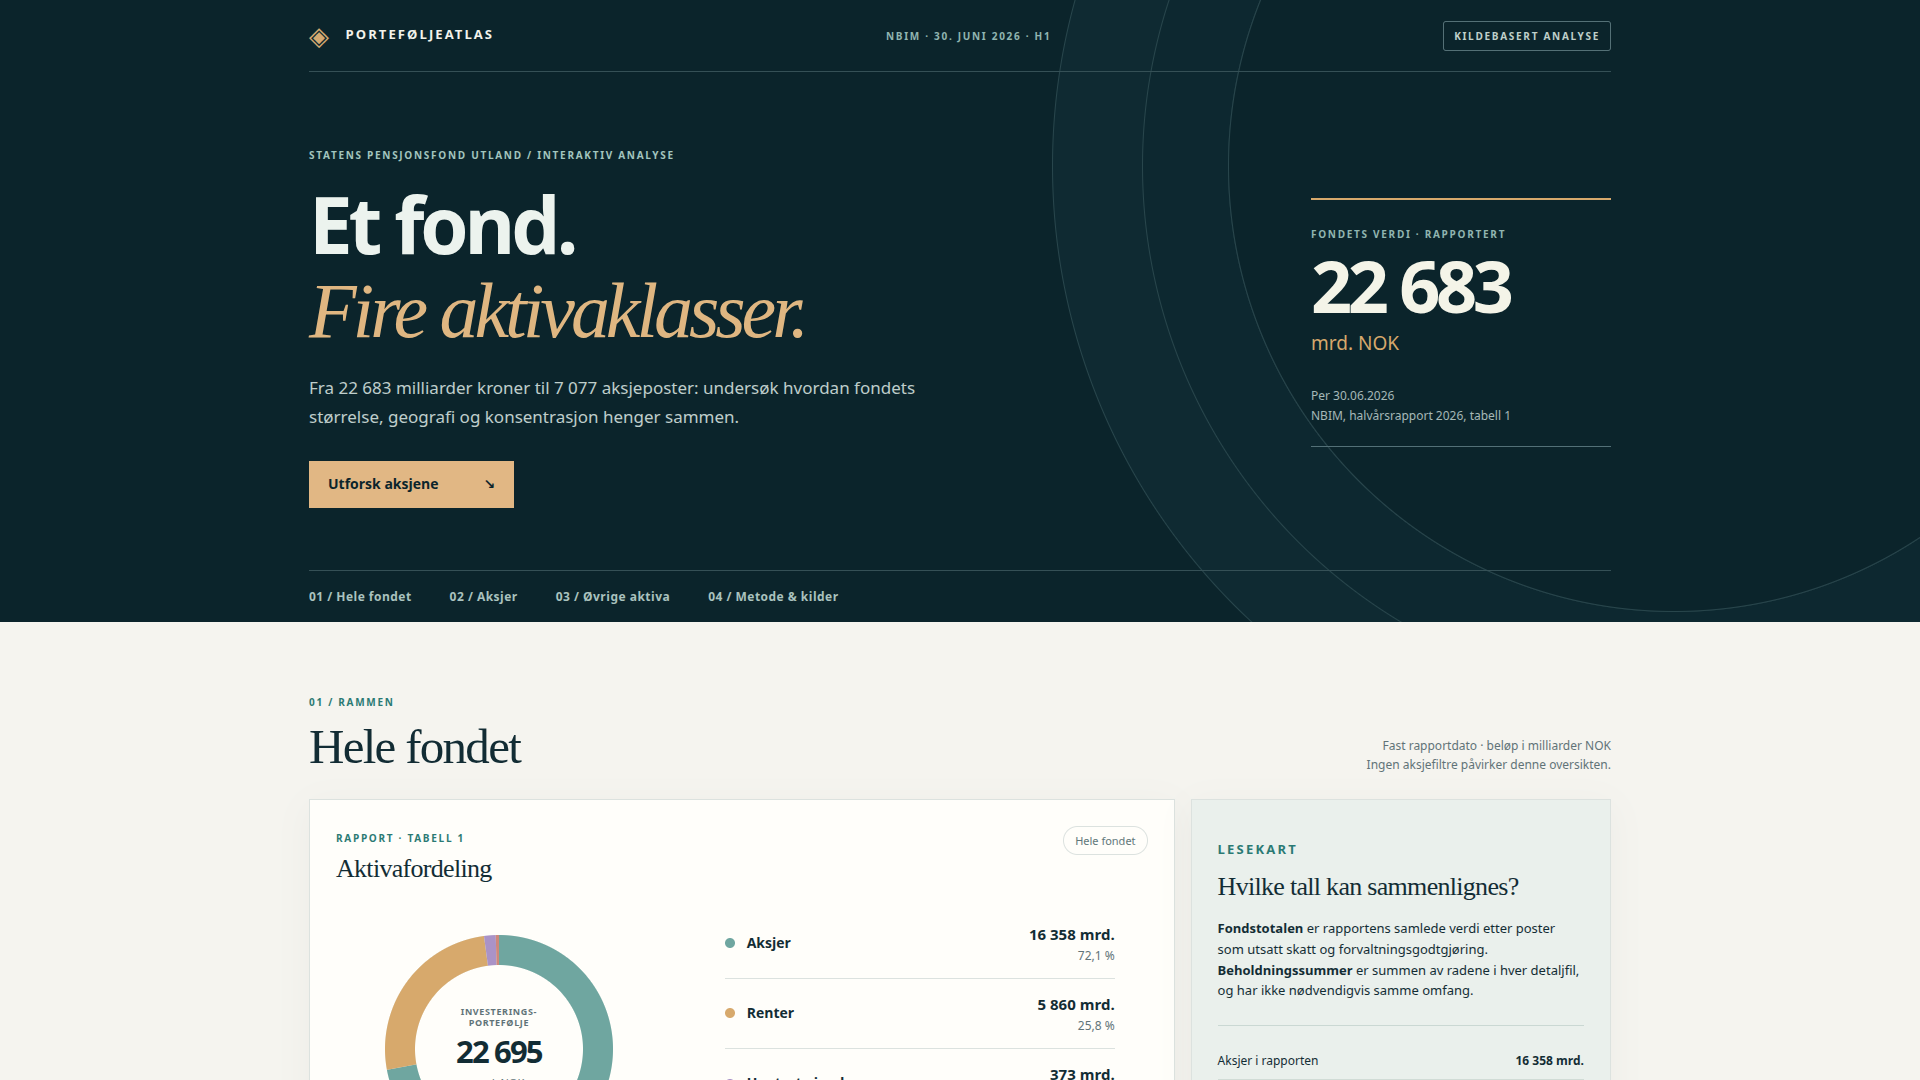
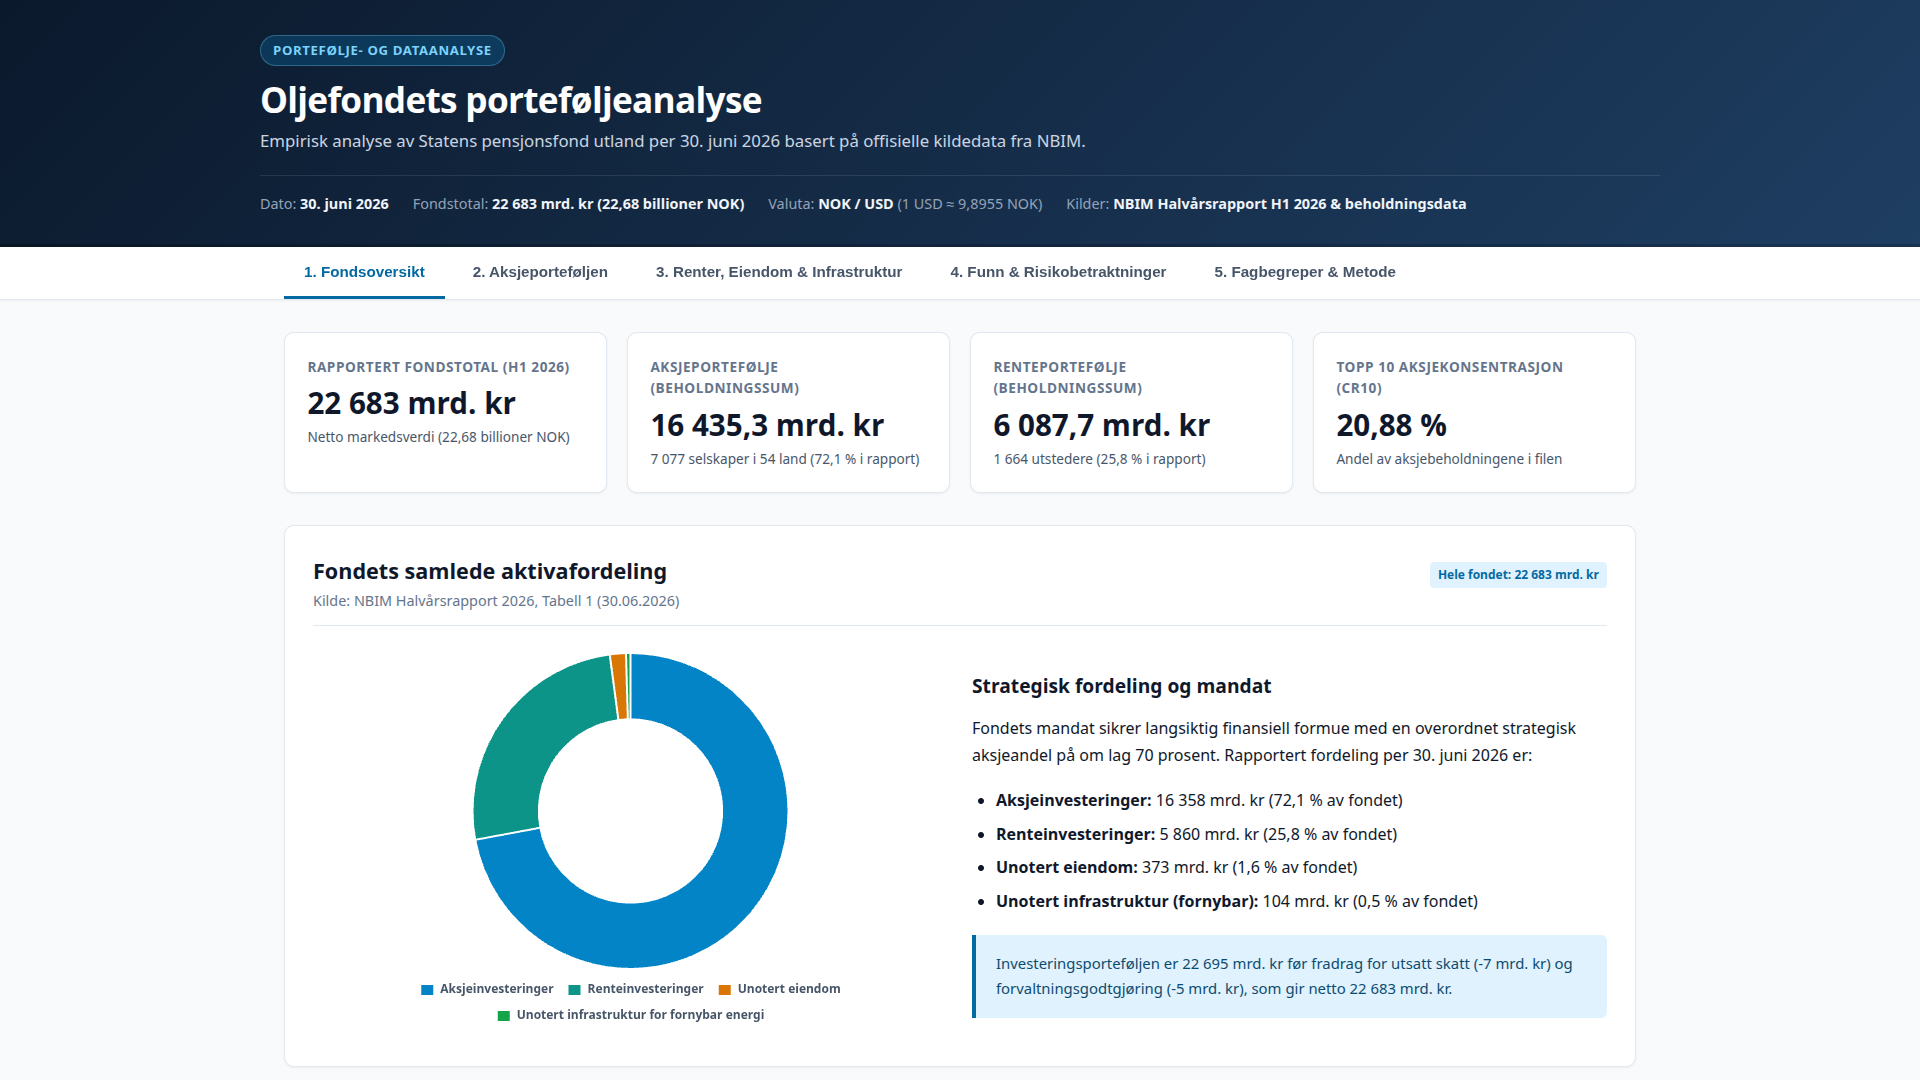
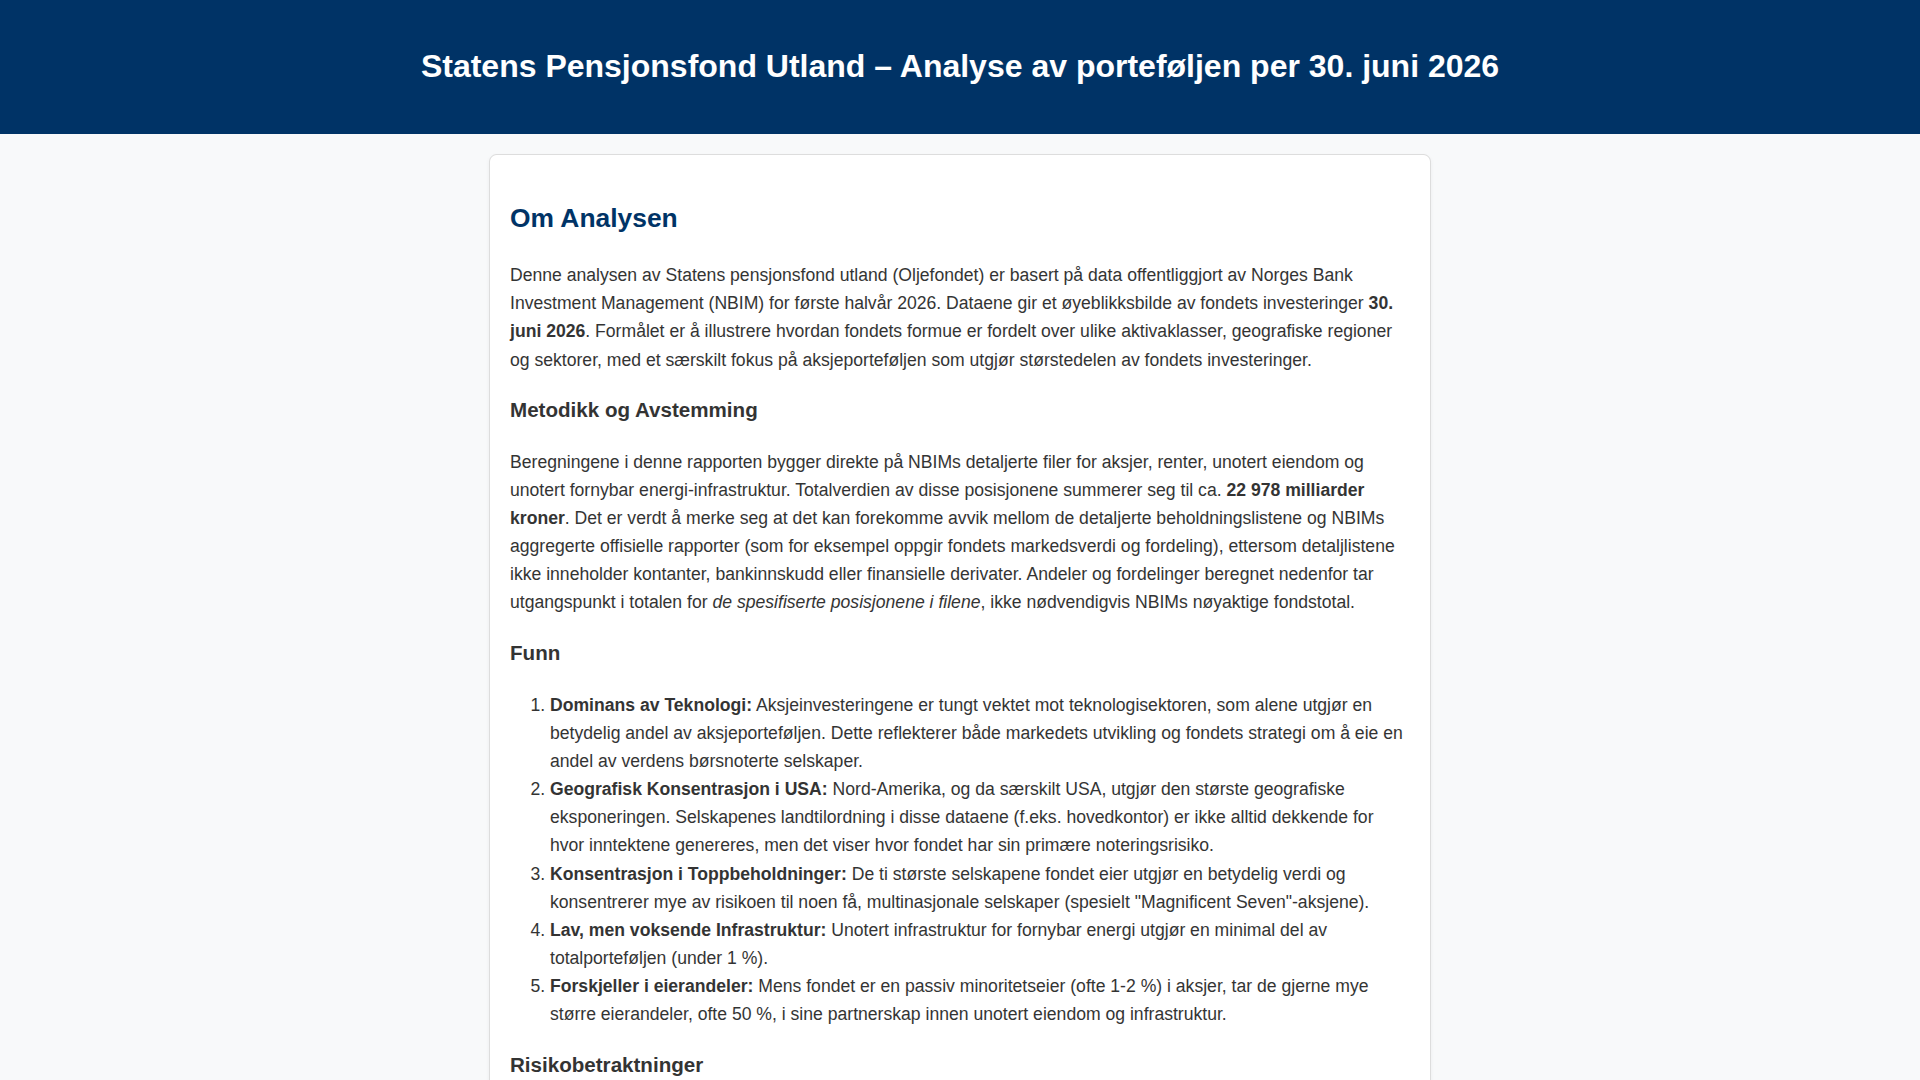
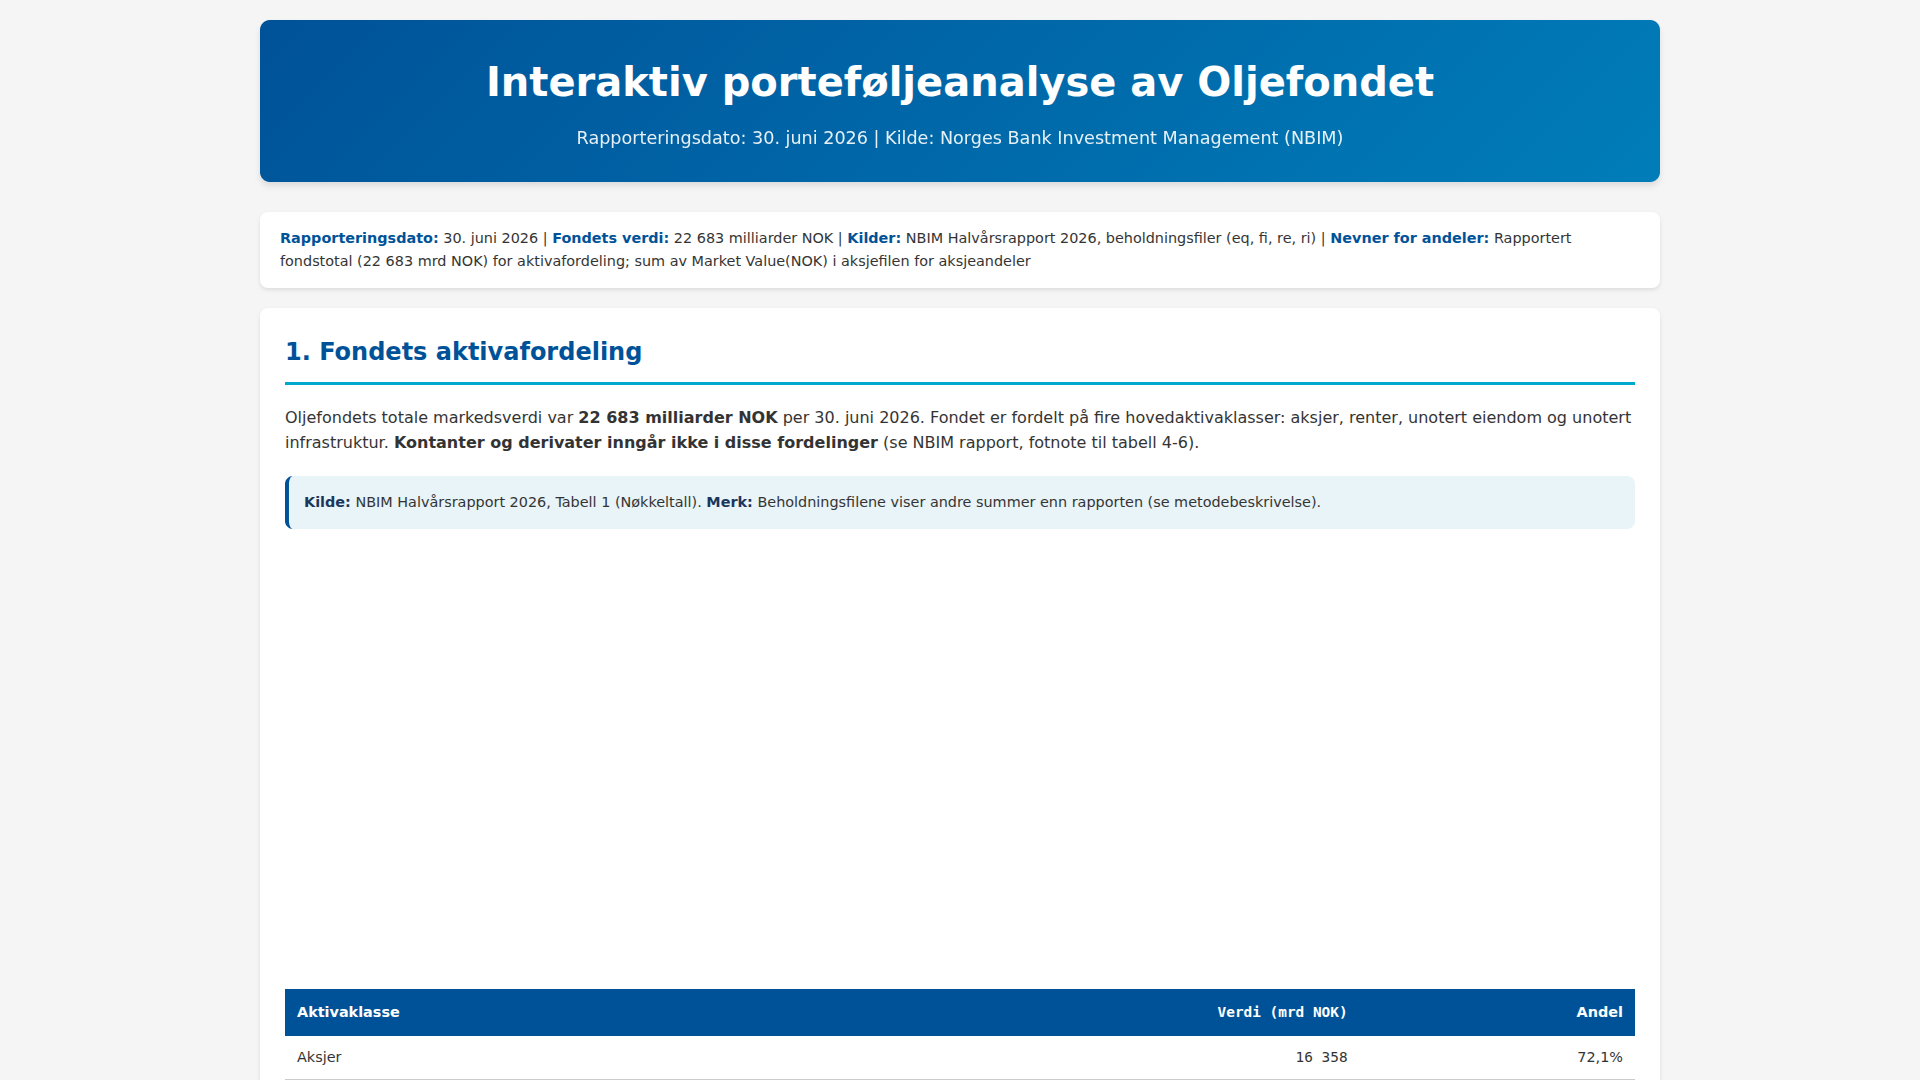
Oljefondet: NBIMs egne beholdningsfiler per 30. juni 2026, med alle 7 077 aksjeselskapene, og den offisielle norske halvårsrapporten.
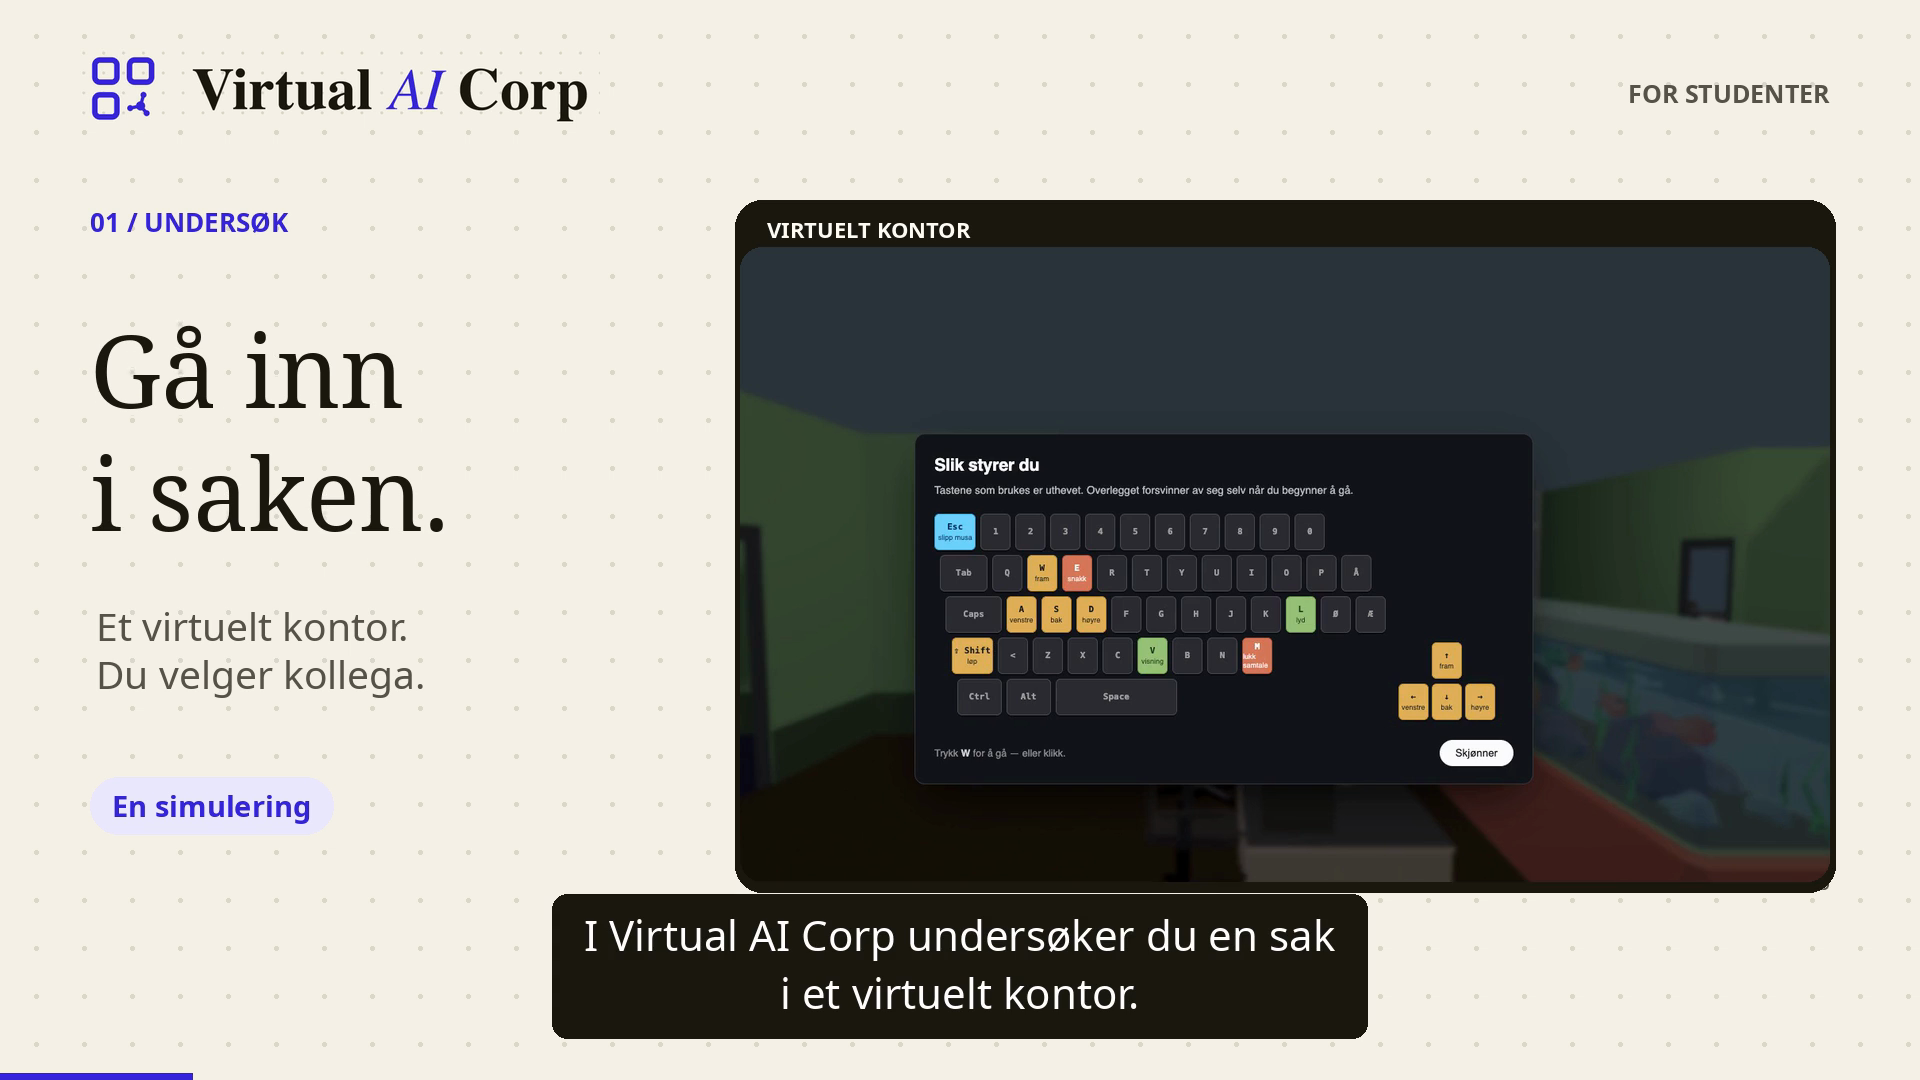
Reklamefilmen: en godkjent norsk studentbrief med kilde for hver påstand, studentvideoen fra forsiden og skjermbilder av våre egne sider.
Filmen skal ha norsk tale med en fast norsk stemme, og norske undertekster.
1
Samme oppgave for alle
Hver modell får den samme oppgaveteksten, det samme materialet og de samme grensene: 30 minutter og 200 steg per oppgave.
2
Et avstengt arbeidsmiljø
Modellen arbeider i en egen beholder uten nett og uten tilgang til våre systemer. Den kan kjøre kode, ta skjermbilder, rendre video og lage presentasjoner.
3
Ingen hjelp underveis
Kjøringen er automatisk fra start til slutt. Vi logger tid, antall steg og faktisk kostnad hos leverandøren.
4
Gjennomgått før publisering
Vi ser gjennom hver leveranse før den publiseres, og vurderer om den fungerer, følger oppgaven, holder god kvalitet og hvor mye etterarbeid den trenger.
Oppgavene
Tre faste oppgaver
Oppgavene er de samme i hver runde, så en ny modell kan sammenlignes med dem som er testet før.
En ferdig film med norsk tale og undertekster om Virtual AI Corps studentinnhold, pluss tre lysbilder som presenterer nettstedet for en student.
Vurderingen
Slik setter vi karakterene
Vi leser hele leveransen, regner nøkkeltallene på nytt, åpner resultatet som en bruker og sjekker hvert punkt i oppgaven. En feil trekkes bare der den hører mest hjemme. Hver modell får ett forsøk per oppgave.
Fire karakterer fra 1 til 5. Snittet av dem er tallet du ser i sammenligningen.
Fungerer
Starter leveransen, og virker den slik den lover? 5 er alt virker uten feil, 1 er at den ikke starter.
Følger oppgaven
Er alt som ble bestilt, levert innenfor rammene? Oppdiktede tall, fakta eller kilder gir høyst 2.
Kvalitet
Faglig, visuelt og kreativt nivå. 5 betyr at den kunne vært vist for studenter slik den er.
Lite etterarbeid
Hvor mye vi måtte gjort før vi kunne brukt den. 5 er ingenting, 1 er at den må gjøres om.
Sammenligning
Slik gjorde modellene det
Kort sagt
Vil du ha det beste resultatet
Velg GPT-6.1 Sol, Claude Opus 5.5 eller GPT-6 Sol. Alle fikk 4,75 av 5 på alle tre oppgavene, og alle var ærlige om egne mangler (5 av 5 på alle tre).
Vil du ha mest for pengene
GPT-6.1 Sol ga samme karakter som Claude Opus 5.5 til 2,42 USD for alle tre oppgavene, mot 5,39 USD.
Vil du ha lav pris og fart
Gemini 3.1 Pro kostet 1,53 USD og brukte 12 min 56 s på alle tre, men snittet er 3,0. Regn med en del etterarbeid.
Må data behandles i EU
Mistral Medium 3.5 er den eneste i testen med behandling i EU. Den fikk 1,5 på droneoppgaven og 2,25 på Oljefondet-oppgaven. Reklamefilmen: leverte ikke innenfor budsjettrammen (23 USD). For oppgaver av denne typen holdt den ikke mål.
Lav listepris er ikke det samme som lav regning. Gemini 3.8 Flash har lavest listepris av modellene, men brukte flest tokens av dem i kjøreren (18,1 millioner inn) og ble den dyreste av dem som leverte alle tre oppgavene (14,44 USD).
Snitt av fire karakterer fra 1 til 5, per oppgave, med ærlighet under. Kostnad er summen for oppgavene modellen leverte.
* Leverte ikke innenfor budsjettrammen (23 USD): Avbrutt 28.09.2026 etter 8,5 minutter uten leveranse: modellens samlede budsjettramme på 23 USD for de tre oppgavene var brukt opp. Snittet for Mistral Medium 3.5 gjelder derfor bare to oppgaver.
Manuelle prøver i leverandørenes egne apper har andre verktøy og ingen fast tidsgrense, og står derfor på egen rad. Kostnad med ≈ er et anslag: hva tokenforbruket i økta ville kostet til leverandørens listepris. Prøvene er betalt via abonnement.
Karakter og pris i samme bilde
Høyt oppe er bedre, langt til venstre er billigere. Kostnaden er gjennomsnittet per levert oppgave. Den hule prikken er en manuell prøve med anslått kostnad.
Resultatene
Hva modellene leverte
Hvert resultat har et bilde av leveransen, karakterene og det vi syntes var best og svakest. Åpne et resultat for å se hele leveransen, kontrollrapporten og hele vurderingen.
Oppgave 1 av 3 · 8 resultater
Droneflyging over NMBU
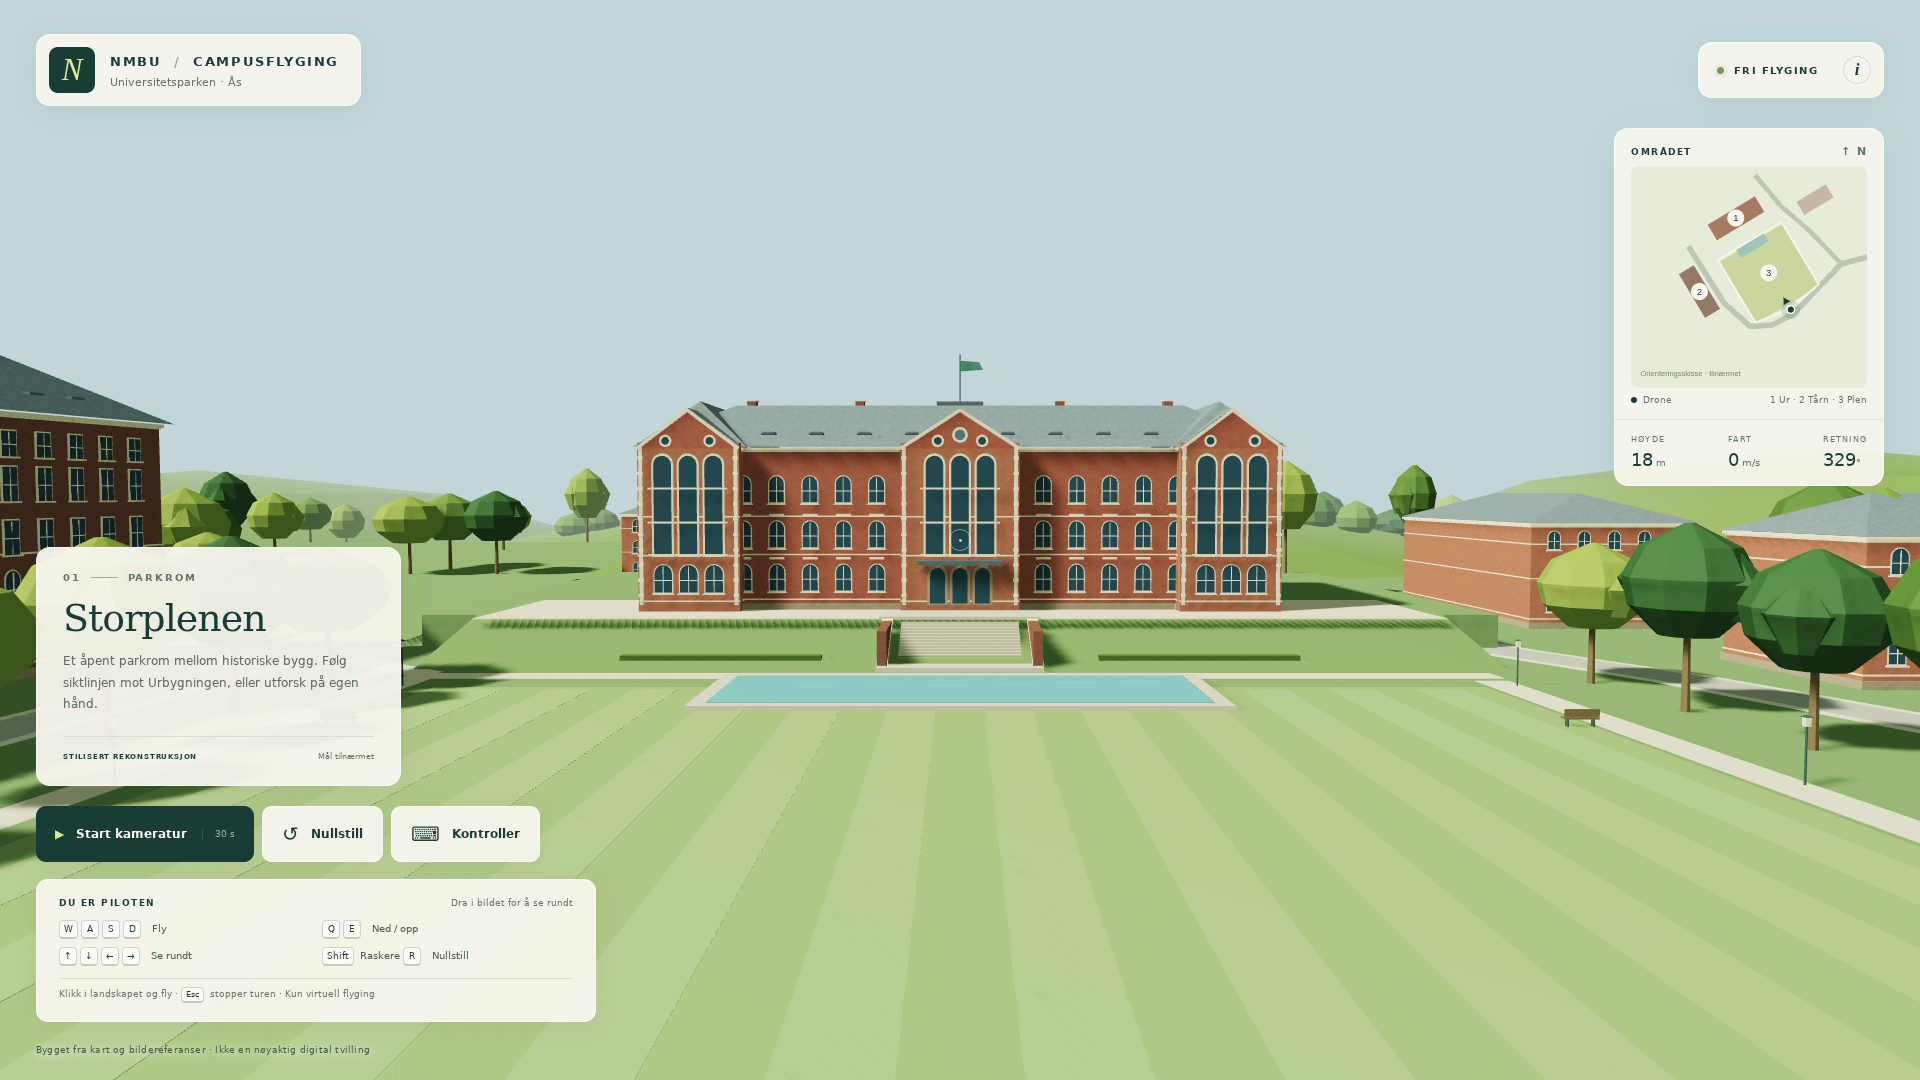
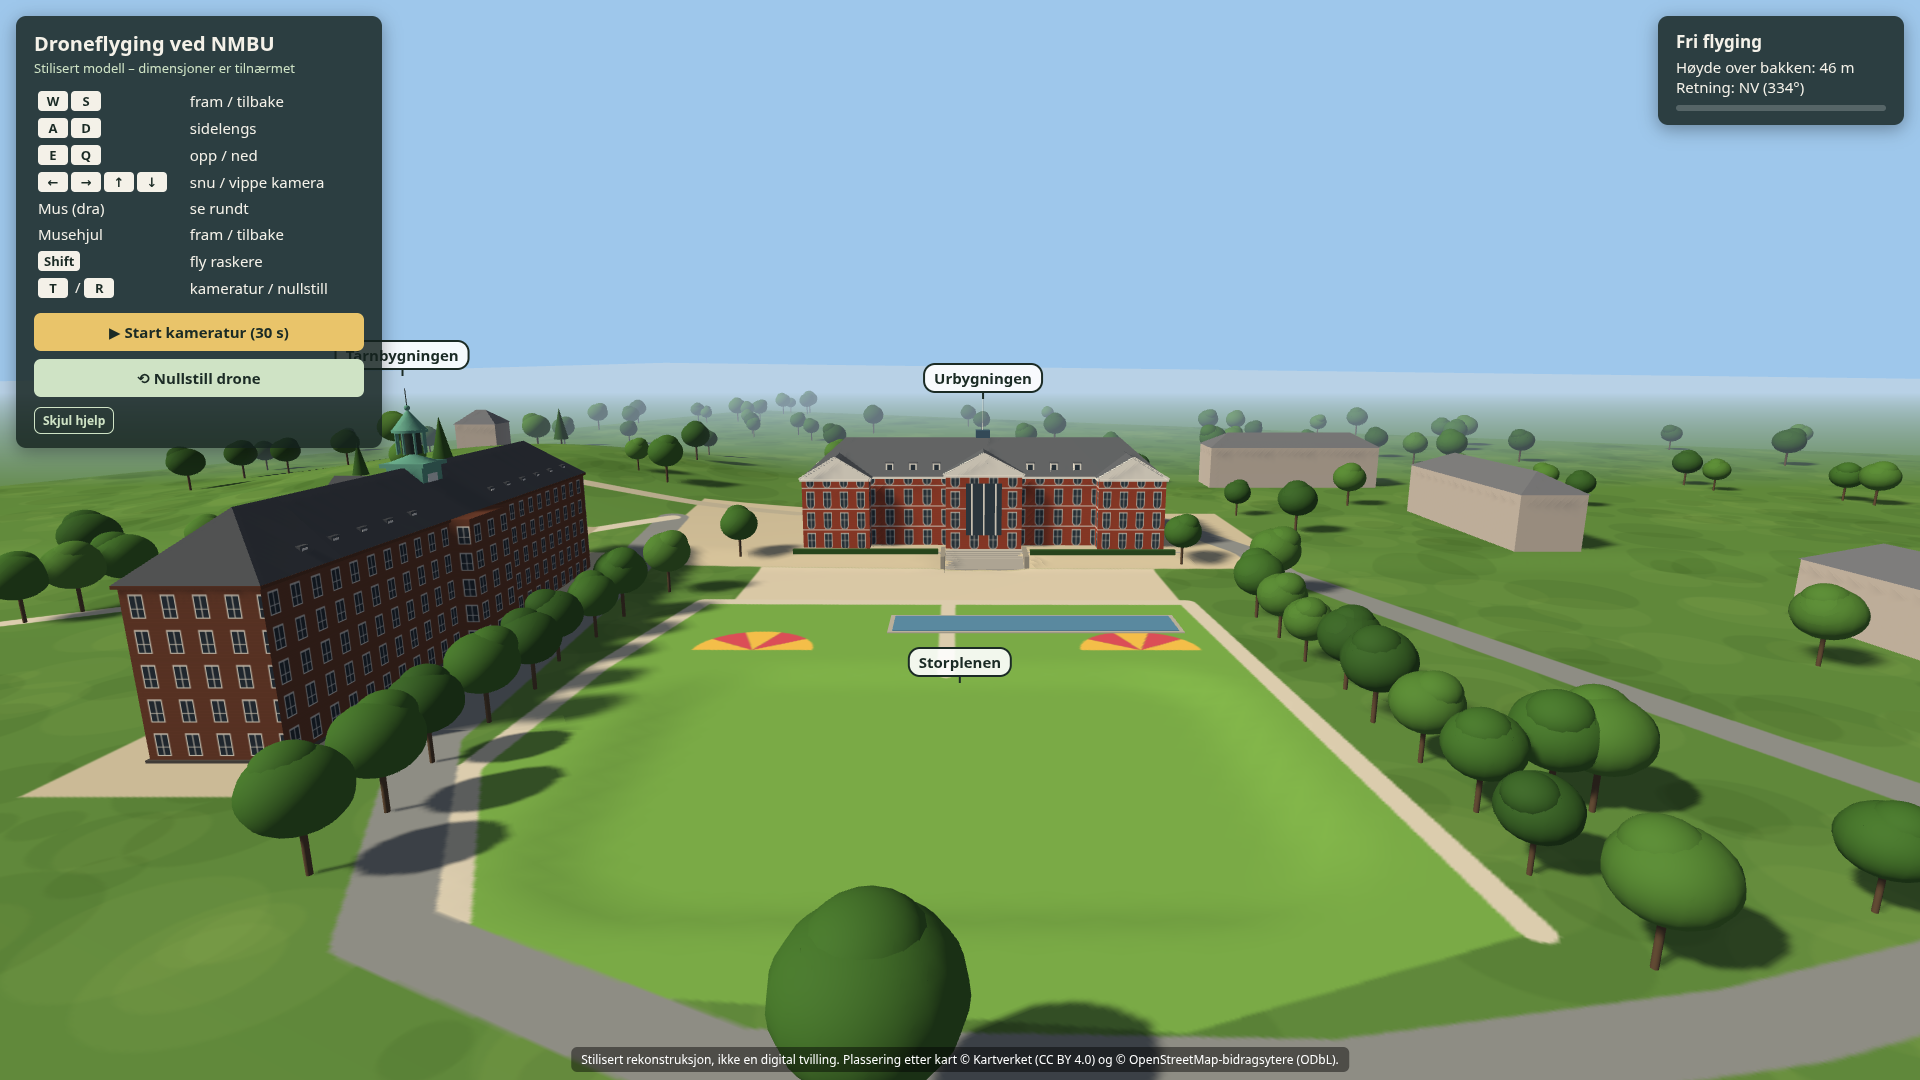
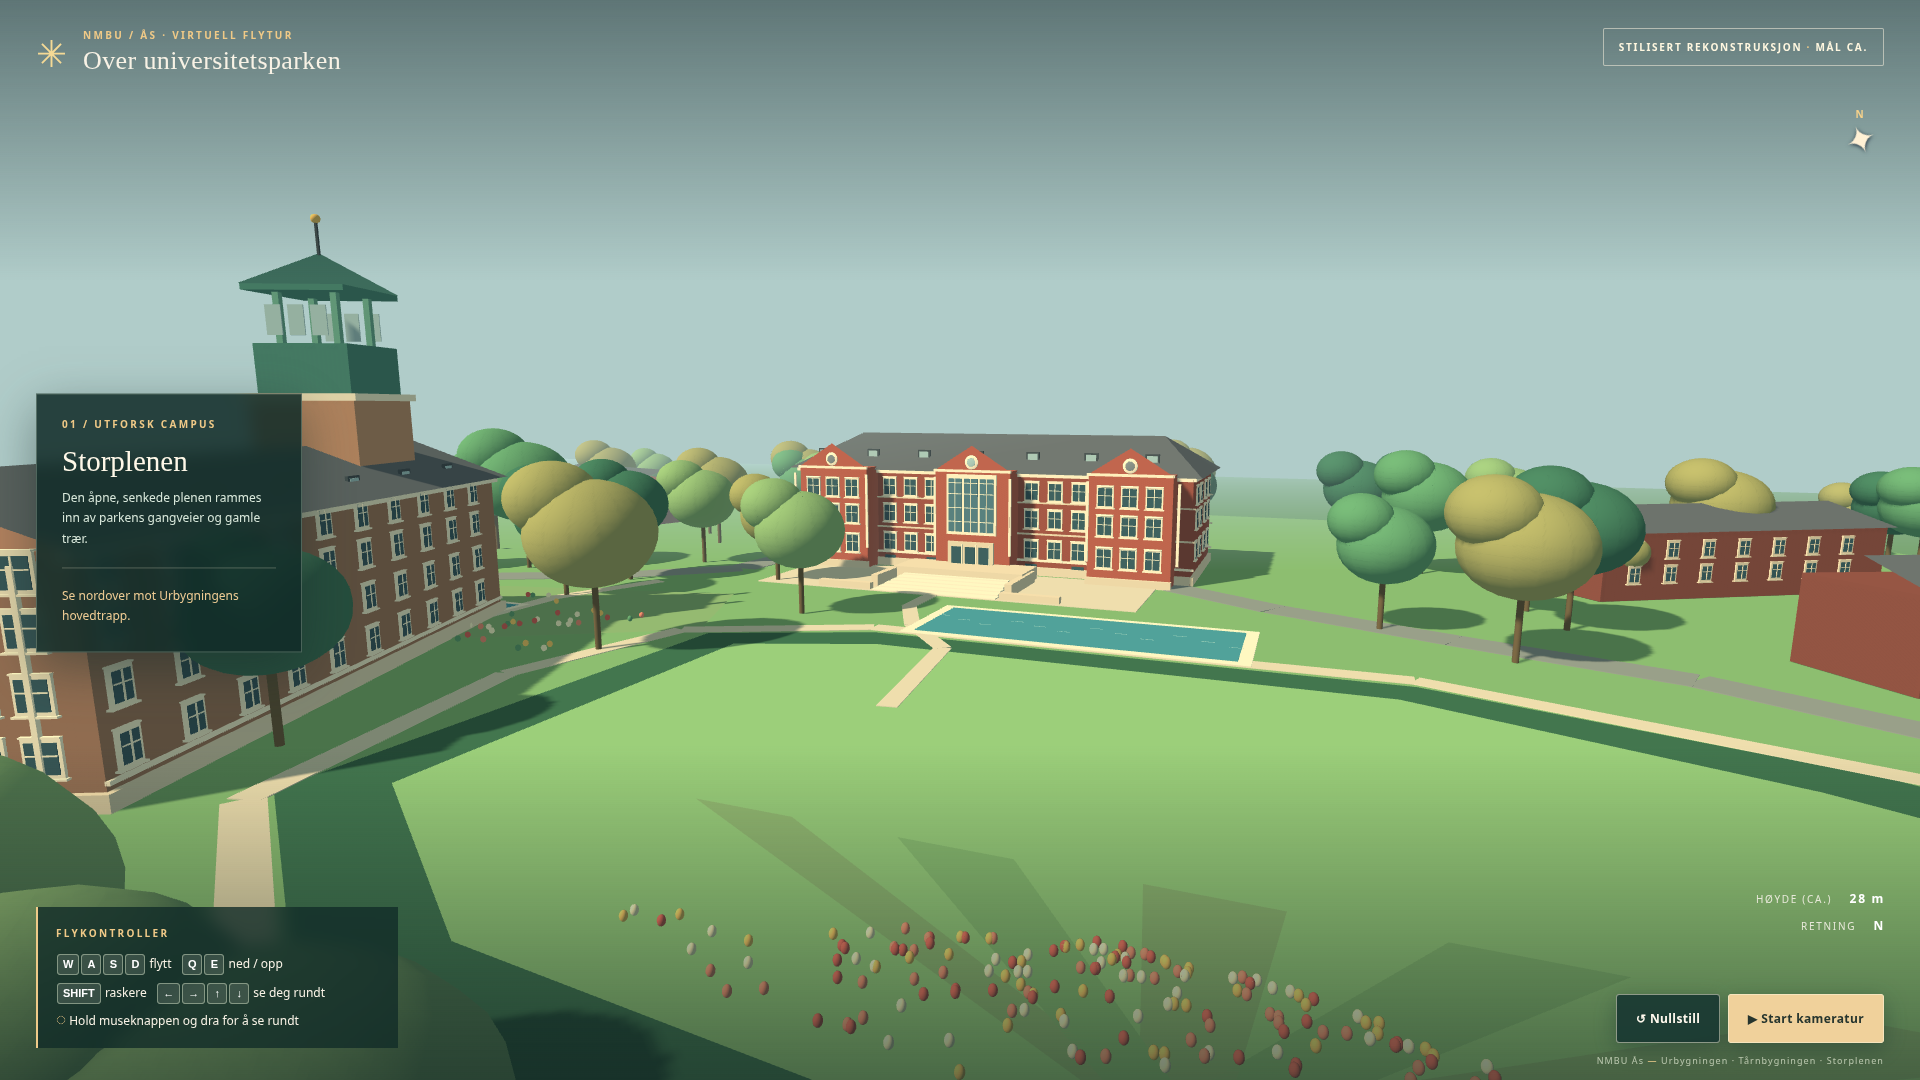
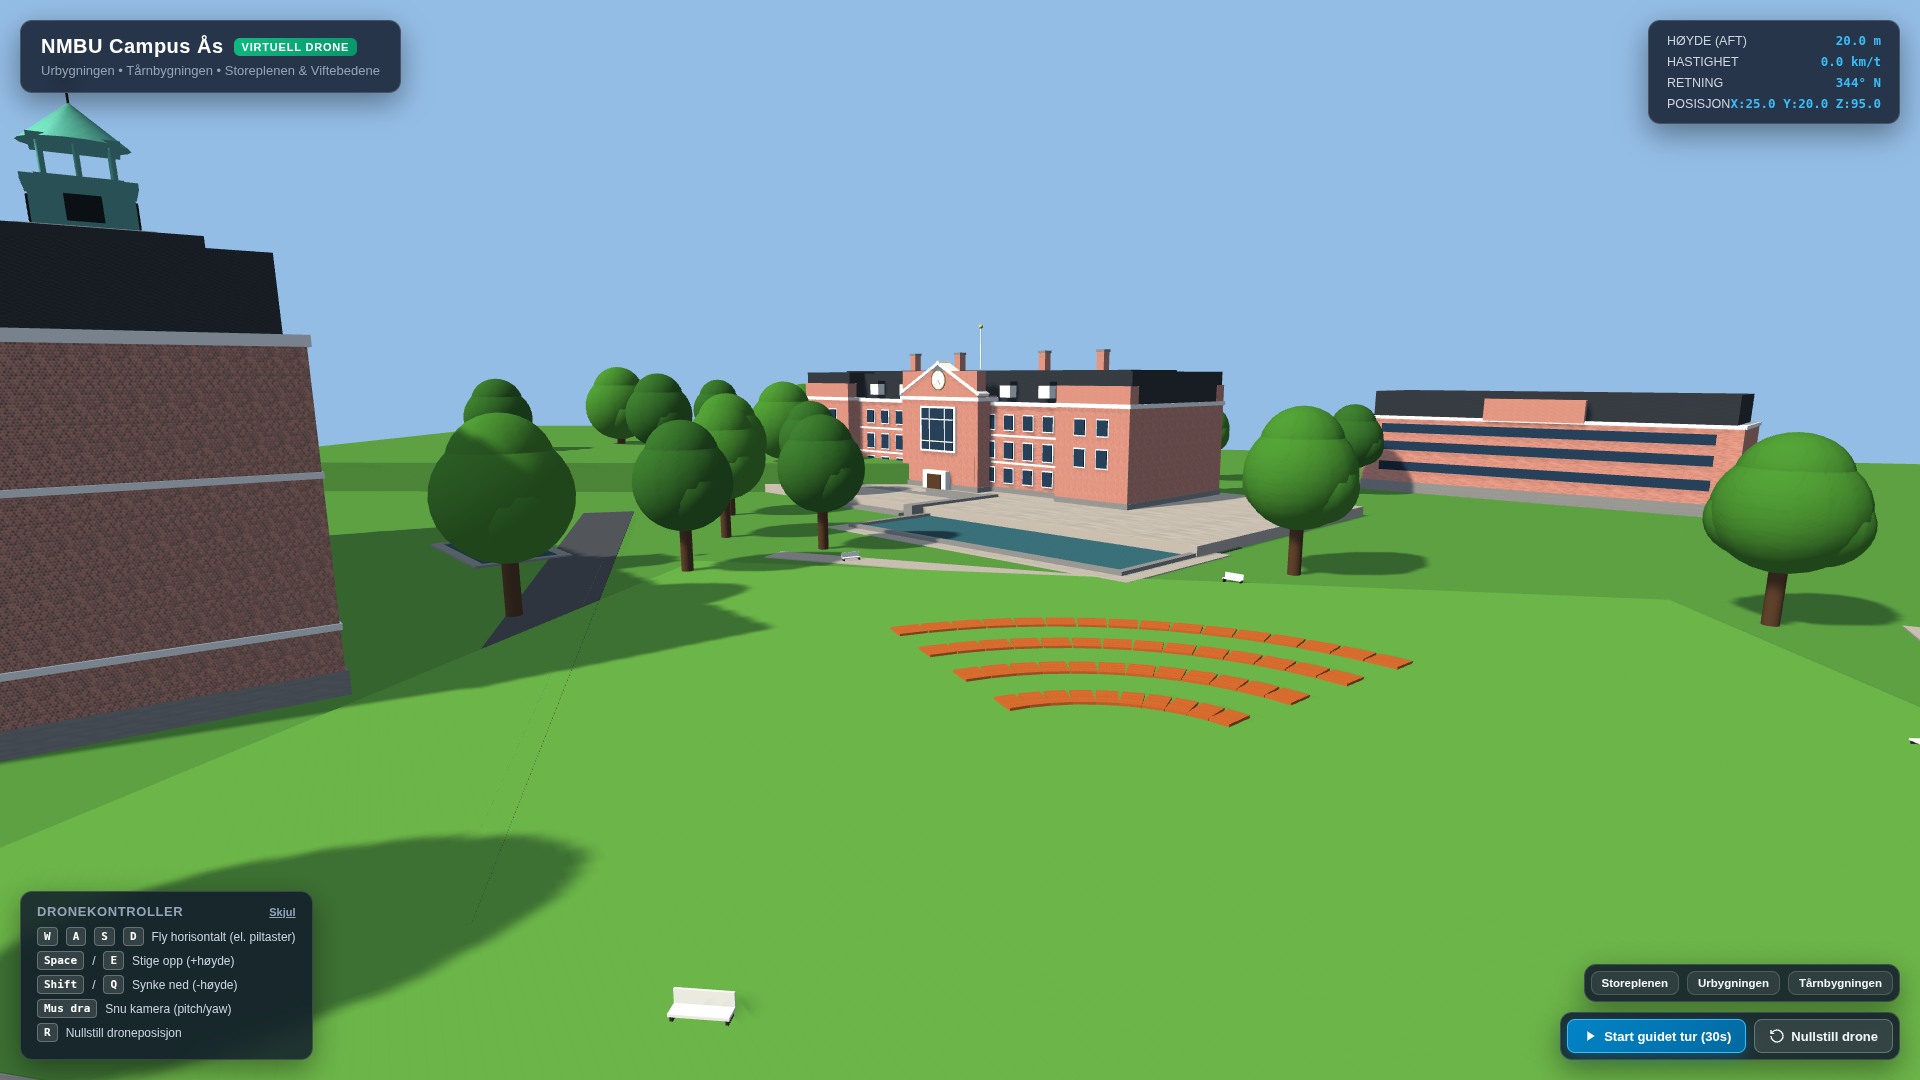
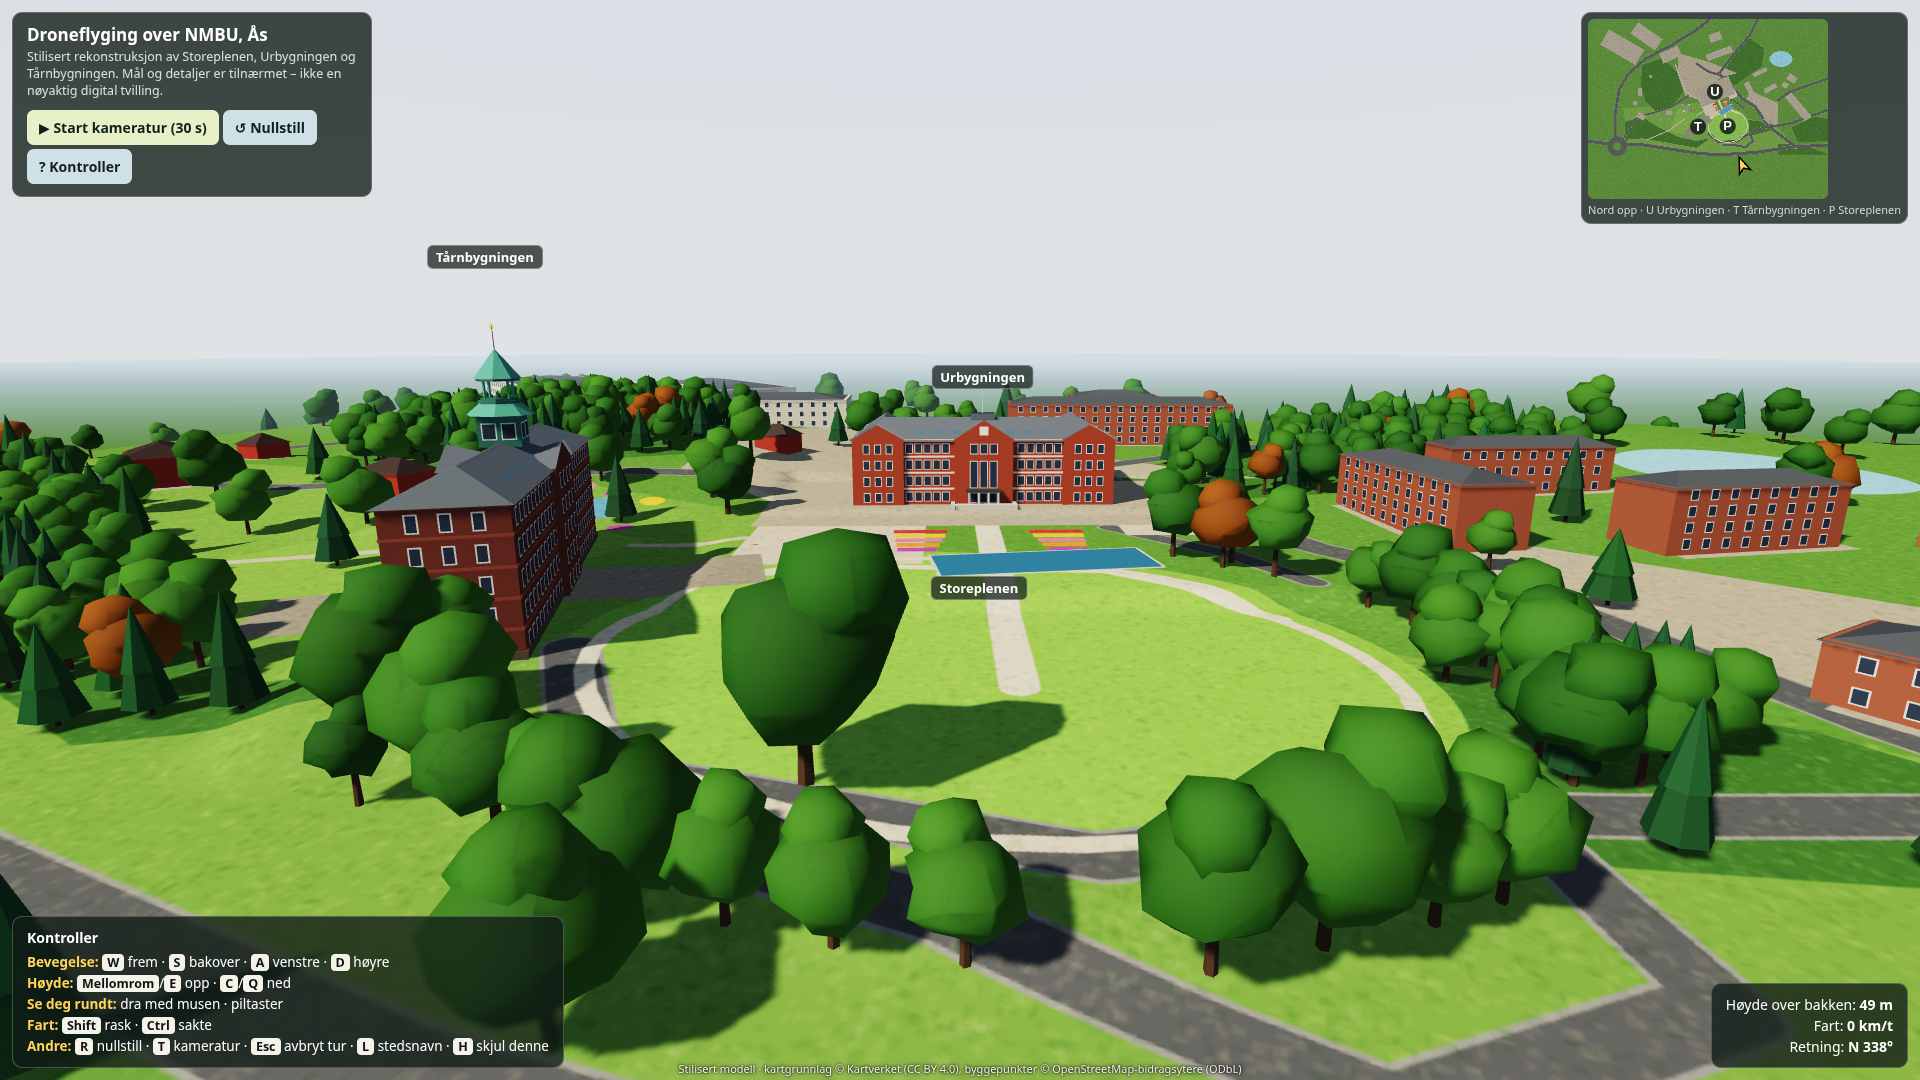
En interaktiv 3D-flytur over Storplenen, Urbygningen og Tårnbygningen i Ås, bygget med PlayCanvas.
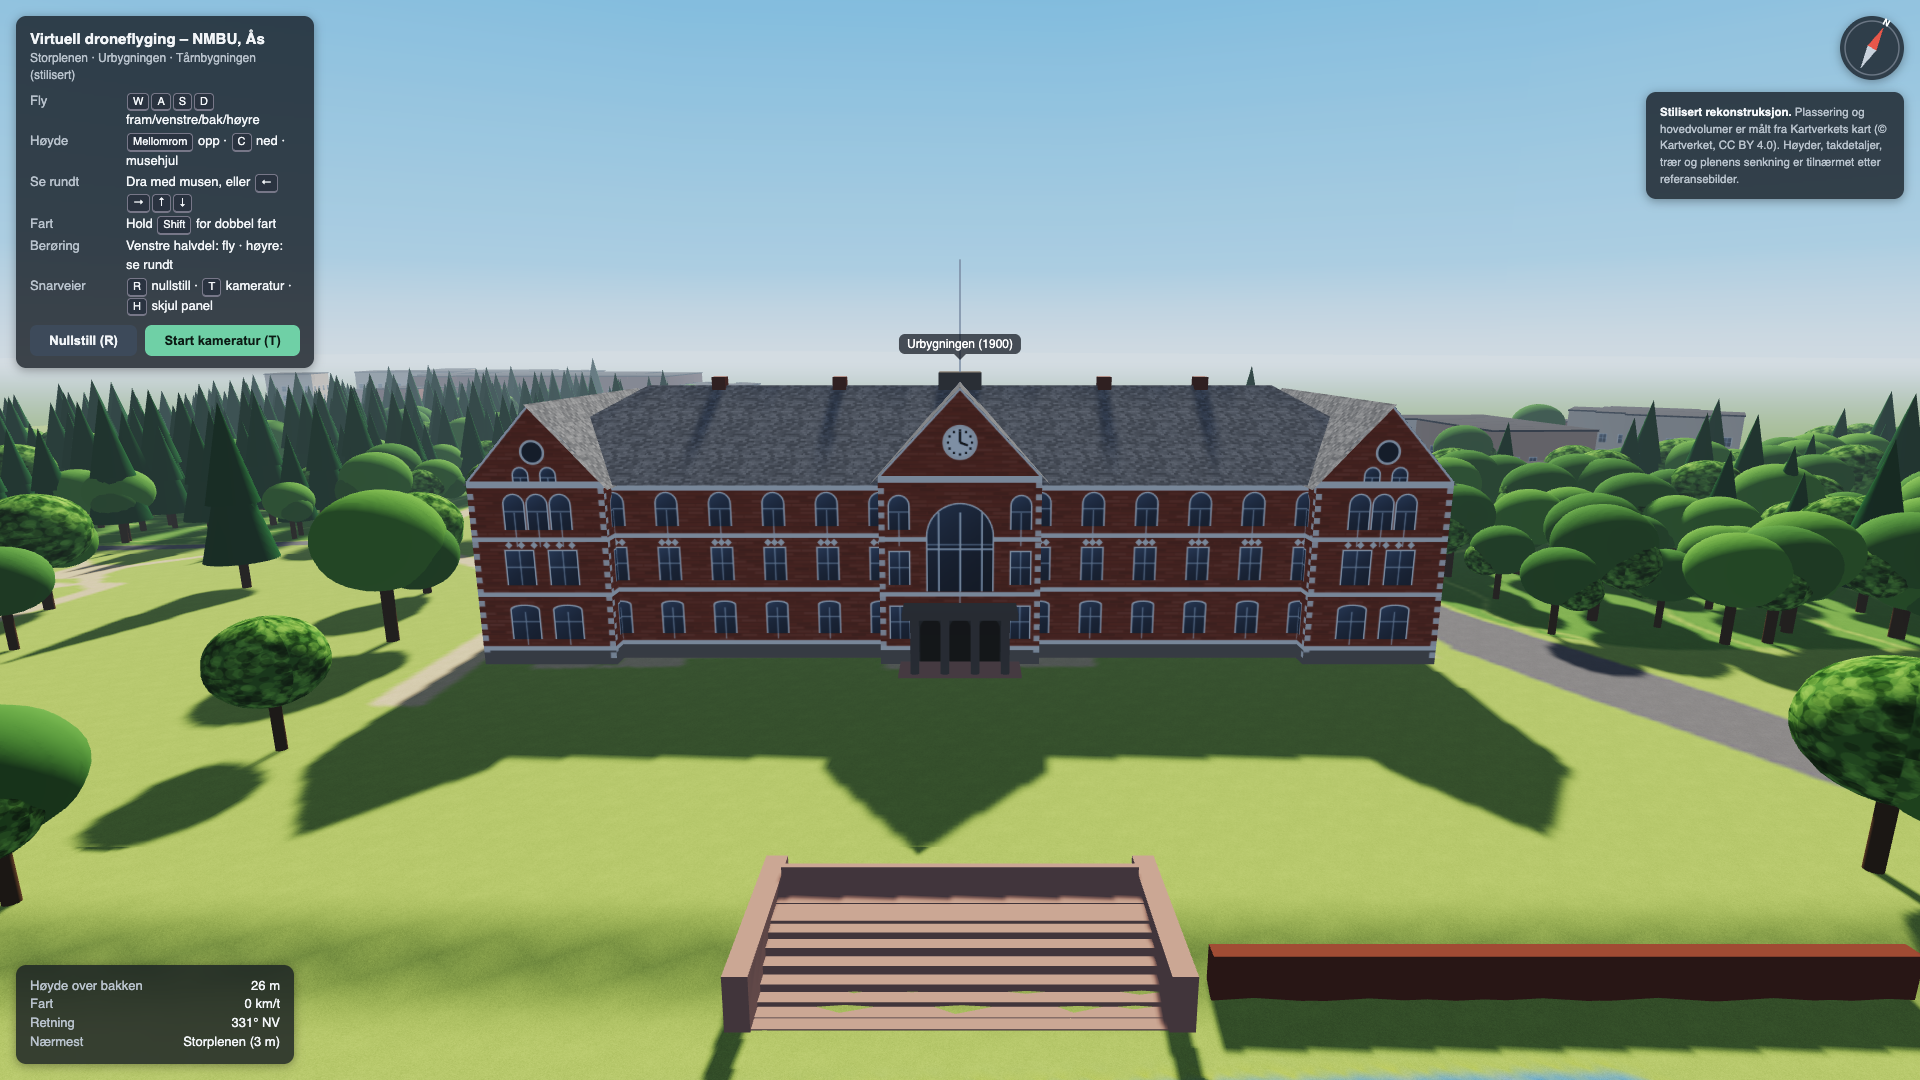
BestDen mest detaljerte dronen i testen: Urbygningen med rundbuede vinduer, gavlfelt og dobbel hovedtrapp ned mot speildammen, Tårnbygningen med grønn lanterne, og en stripet plen med trær, benker og lyktestolper.
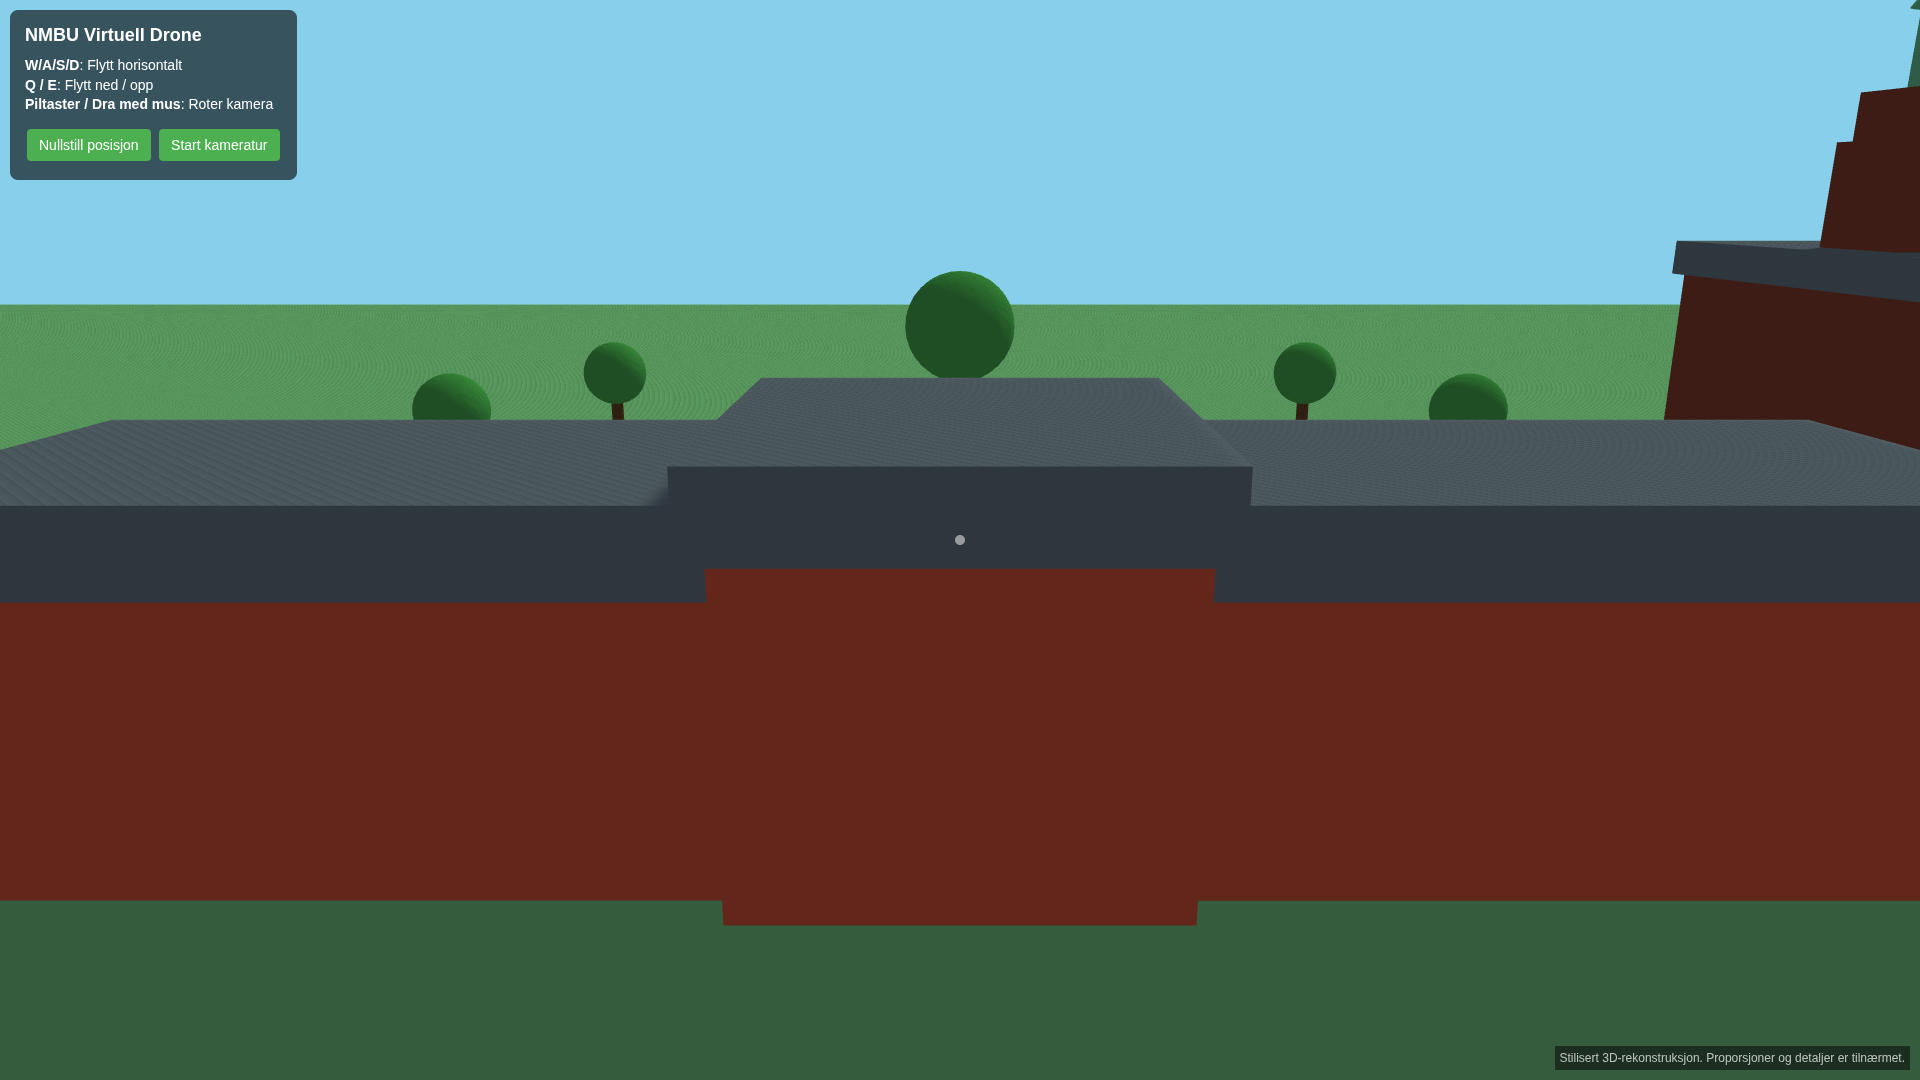
SvakestIngen berøringskontroller for fri flyging på mobil (oppgitt i README).
BestDen mest gjenkjennelige dronen: buede vinduer og bred hovedtrapp på Urbygningen, lanternen midt på Tårnbygningen, viftebed, Speildammen og senket plen, med navneskilt på stedene.
BestGjenkjennelige bygninger: Tårnbygningen med lanternen midt på, Urbygningen med klokke og gavler, og viftebedene på Storeplenen.
SvakestKontrollrapporten kaller bygningene «nøyaktig modellert» og sier at «samtlige krav» er oppfylt, før den lenger ned kaller det en stilisert rekonstruksjon.
BestGjenkjennelig campus: Urbygningen med gavlrisalitter og takvinduer, Tårnbygningen med grønn lanterne og spir, senket plen med ringsti, viftebed og Speildammen, pluss minikart og stedsnavn.
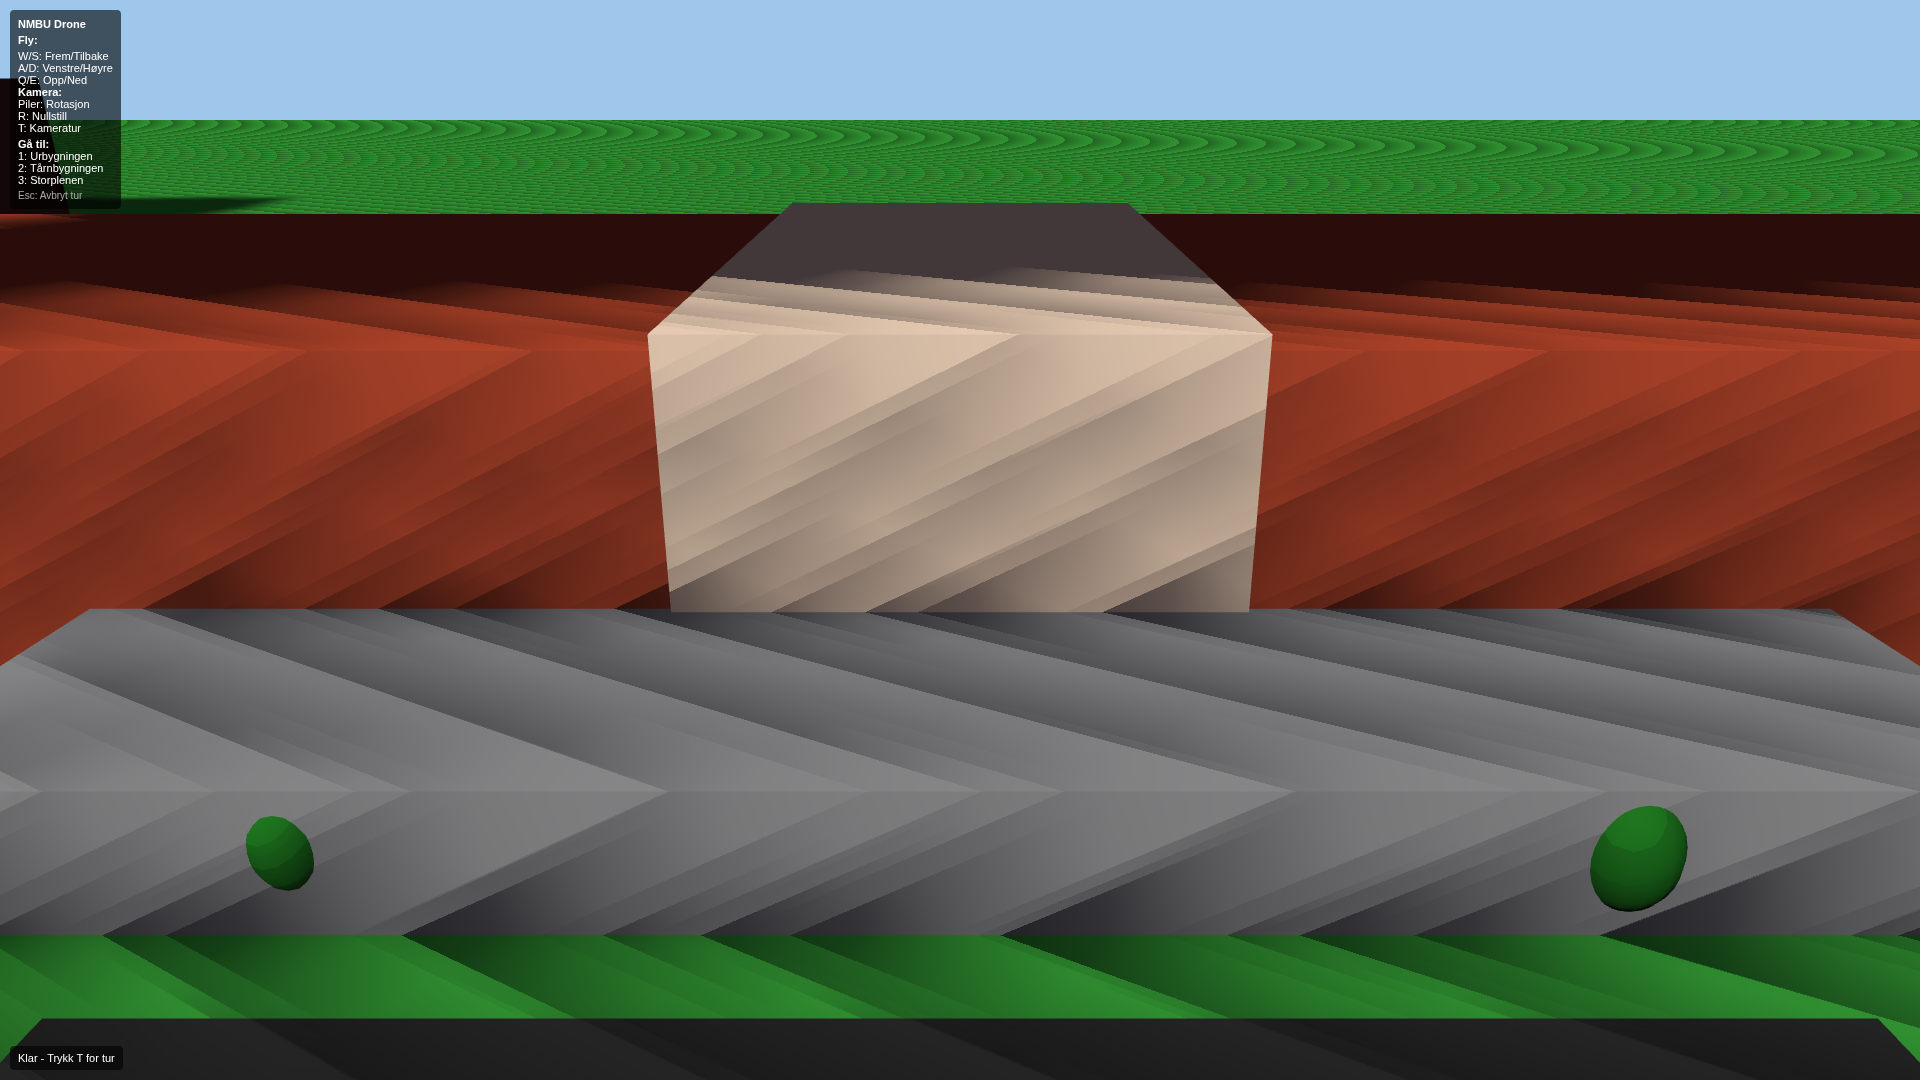
SvakestKnappen «Start kameratur» gjør ingenting: den har to klikklyttere, der den ene starter turen og den andre stopper den straks. Det samme gjelder «Kjør kameraturen på nytt». Turen kan bare startes med T.
Manuell prøveClaude Code på Macen, Fable 5.1 (High)
42 min 0 s · ≈ 21,54 USD (anslag, betalt via abonnement)
Fungerer
5
Følger oppgaven
5
Kvalitet
5
Lite etterarbeid
4
Ærlighet
5
BestGjenkjennelige bygninger: paviljonggavlene, urgavlen og portalen på Urbygningen, og lanternen midt på Tårnbygningen. Stedene står på riktig plass fordi Kartverket-kartet er georeferert.
SvakestHovedtrappen står løst i gresset langt foran fasaden, og terrassen foran Urbygningen er gress.
Oppgave 2 av 3 · 8 resultater
Oljefondet som læringsressurs
En interaktiv analyse av fondets portefølje per 30. juni 2026, bygget på NBIMs originaldata.
BestAlle nøkkeltall stemmer ved etterregning: aksjer 16 435,35 og renter 6 087,66 mrd. kr, USA 54,47 %, teknologi 32,09 %, tre største sektorer 60,68 %, topp 10 20,88 %, topp 100 47,84 %, NVIDIA 3,72 %, HHI 65,14 og effektivt antall 153,5; eiendom og infrastruktur med én landtotal per land (371,2 og 83,4 mrd.).
SvakestLandnavn står på engelsk (NBIMs), sektornavn er oversatt.
BestAlle nøkkeltall stemmer ved etterregning fra NBIM-filene: aksjer 16 435,3 og renter 6 087,7 mrd. kr, USA 54,5 %, teknologi 32,1 %, ti største 20,9 %, 115 selskaper for halve verdien, effektivt antall 154, amerikansk teknologi 22,9 % og 538 selskaper med annet registreringsland.
SvakestSiden ruller sideveis på mobil (577 px innhold i 375 px bredde); modellen oppgir selv at mobil ikke er testet.
BestAlle filsummer stemmer med kontrolltallene, og avstemmingen mot både tabell 1 og balansen viser hvert avvik (+77, +228 og −21 mrd.) uten å tvinge dem til å stemme.
SvakestLandnavnene står på engelsk, mens sektorene er oversatt.
BestAlle nøkkeltall stemmer, og avstemmingen viser hvert avvik mot tabell 1 og balansen (aksjer +77,35 og renter +227,66 mrd.) uten å tvinge dem sammen.
BestAlle nøkkeltall stemmer (aksjer 16 435,3 mrd., topp 10 20,88 %, teknologi 32,09 %), og avstemmingen dekker alle fire aktivaklasser mot både tabell 1 og balansen.
SvakestTar inn et faktum som ikke står i pakken (strategisk aksjeandel på om lag 70 prosent).
Manuell prøveClaude Code på Macen, Fable 5.1 (High)
22 min 0 s · ≈ 14,01 USD (anslag, betalt via abonnement)
Fungerer
5
Følger oppgaven
4
Kvalitet
5
Lite etterarbeid
4
Ærlighet
5
BestAlle nøkkeltall og rapporttall stemmer ved etterregning (aksjer 16 435 mrd. mot 16 358 i tabell 1 og 16 505 i note 5.1; USA 54,5 %, teknologi 32,1 %, topp 10 20,9 %, 115 selskaper for halve verdien; sektoravvik under 0,2 pp mot tabell 5).
SvakestInnledningen sier som fakta at filene utelater kontanter, derivater og uoppgjorte handler, noe pakken sier ikke er dokumentert og modellen ellers kaller tolkning.
Oppgave 3 av 3 · 7 resultater
30 sekunders reklamefilm
En ferdig film med norsk tale og undertekster om Virtual AI Corps studentinnhold, pluss tre lysbilder som presenterer nettstedet for en student.
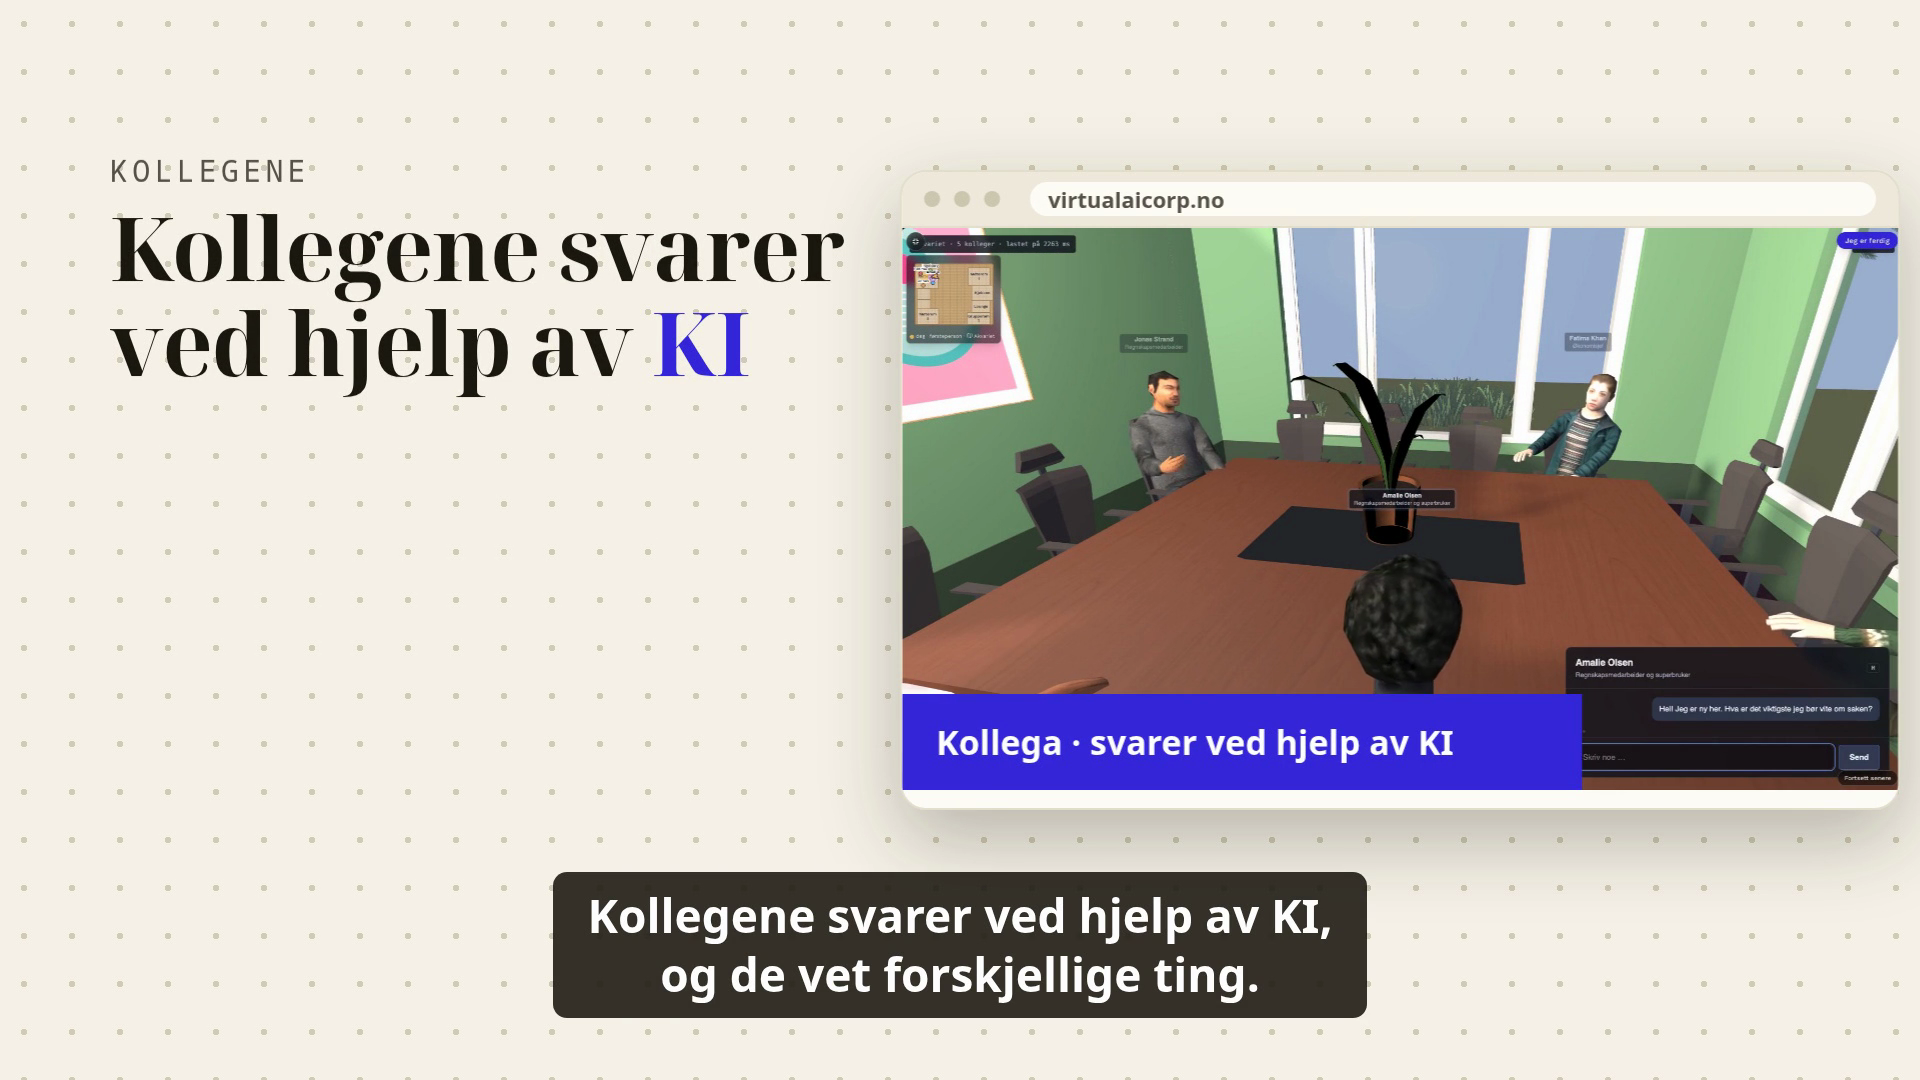
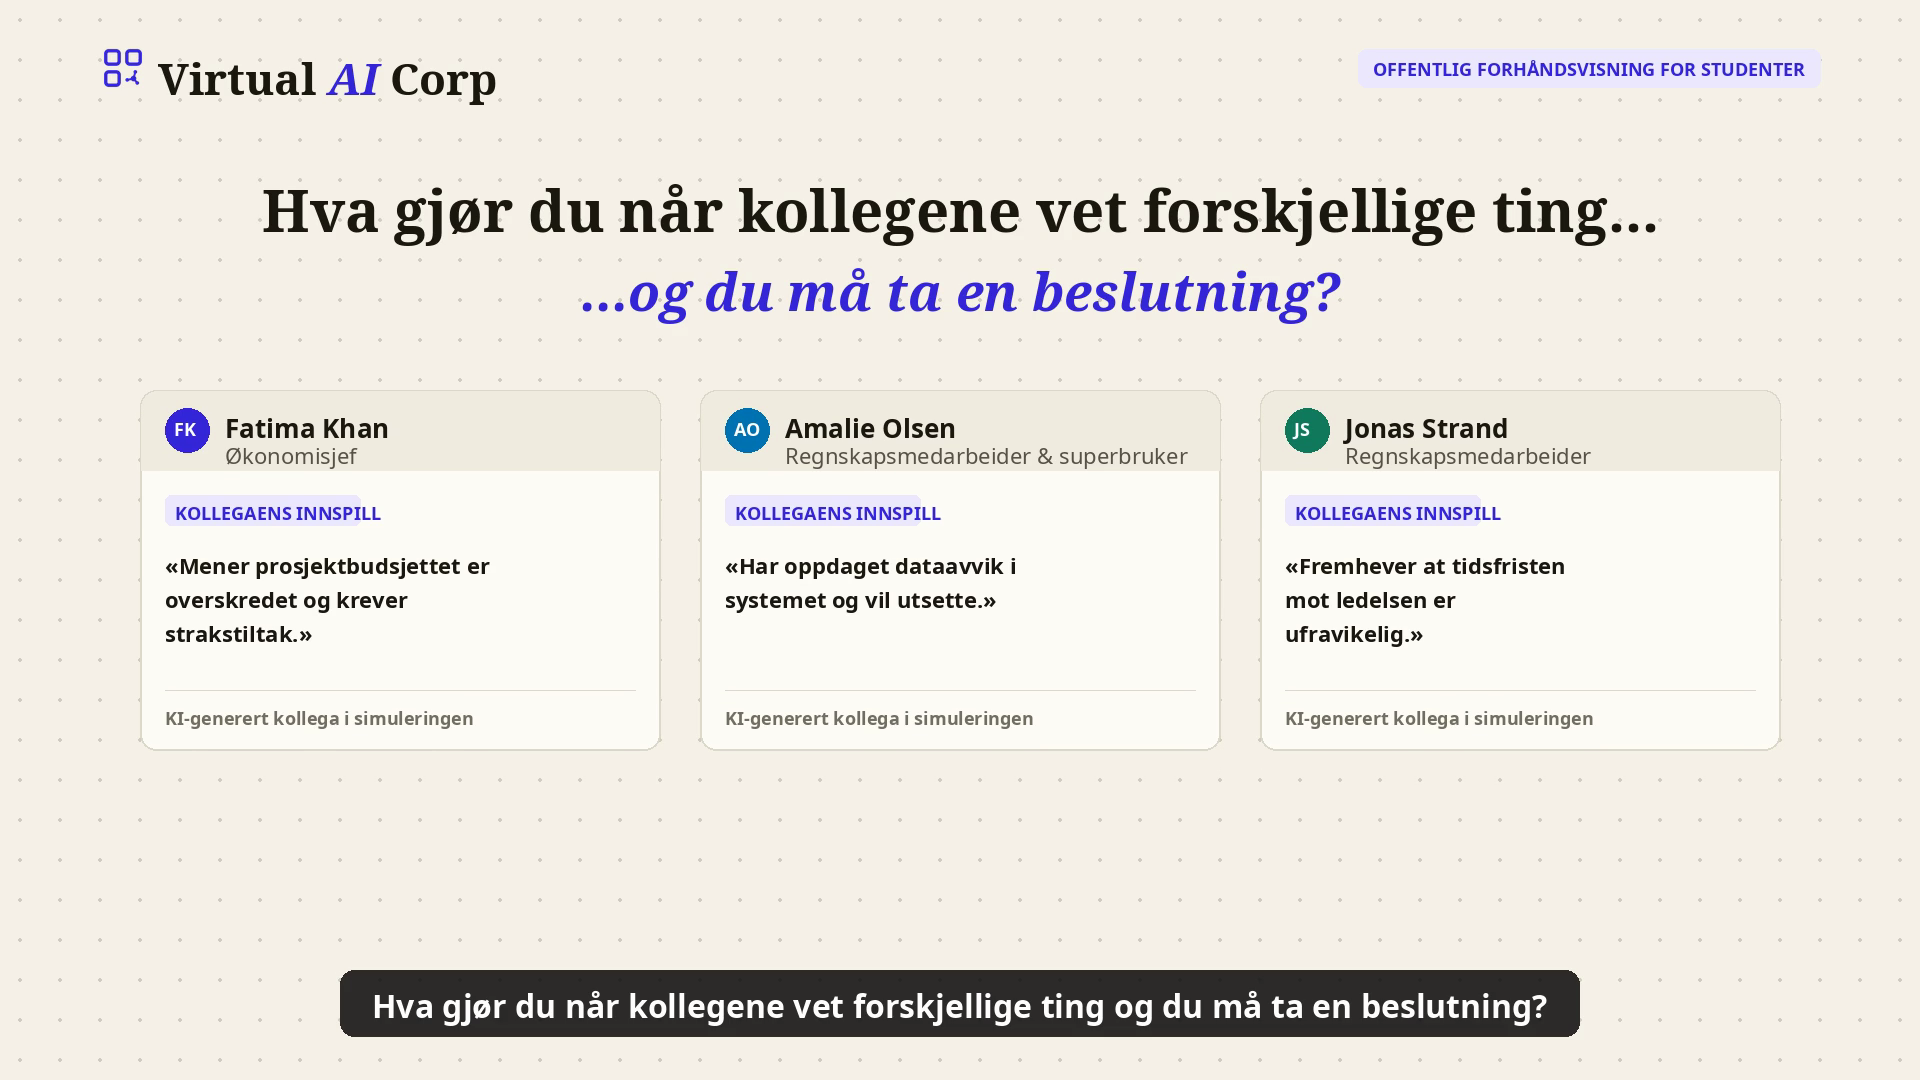
BestSterk krok: «Hvem vil du spørre først?» med en kollegagraf som vokser fram fra første bilde, deretter kontoret, «Still spørsmål. Vurder svarene. Ta en beslutning.» og en sluttplakat med adressen som står i over seks sekunder.
BestHver påstand i manuset er ført tilbake til punktet i den godkjente briefen, og oppfordringen er nøyaktig «Prøv en simulering – uten konto og uten kode».
SvakestTalen er ferdig på 24,9 s, så sluttplakaten står stille i fem sekunder uten lyd.
BestTeknisk eksakt: 900 bilder = 30,000 s, H.264 High + AAC, 1920 × 1080; talen (24,2 s) får plass, og undertekstene følger den innenfor 0,1 s.
SvakestOppdiktet sakinnhold: tre «kollegaens innspill» i scene 1 (budsjett overskredet, dataavvik, tidsfrist) og roller og holdninger på lysbilde 2 står ikke i pakken; saken i studentvideoen er en annen.
Manuell prøveClaude Code på Macen, Fable 5.1 (High)
19 min 0 s · ≈ 9,35 USD (anslag, betalt via abonnement)
Fungerer
5
Følger oppgaven
5
Kvalitet
4
Lite etterarbeid
4
Ærlighet
4
BestFaktatro: hver påstand er ført tilbake til studentbriefen, og oppfordringen «Prøv en simulering» og adressen virtualaicorp.no/forhandsvisning er de godkjente.
SvakestSerifskriften mister tverrstreken i H og A: kroken leses «I lvem ville du spurt?» og ordmerket «Virtual Λ/ Corp».
Ingen leveranse
Mistral Medium 3.5
ikke vurdert
Mistral AI
Leverte ikke innenfor budsjettrammen (23 USD)
Avbrutt 28.09.2026 etter 8,5 minutter uten leveranse: modellens samlede budsjettramme på 23 USD for de tre oppgavene var brukt opp.
Andres målinger
Hva sier internasjonale målinger?
Våre egne tester viser hvordan modellene løser tre konkrete oppgaver. Her er hva uavhengige, internasjonale målinger sier om de samme modellene. Tallene er målt av andre, med andre oppgaver og innstillinger, og er ikke kontrollert av oss.
Internasjonale målinger av modellene vi har testet, med leverandørenes listepriser til slutt. Høyeste verdi blant våre modeller er uthevet.
Rull sidelengs for alle målingene. Listeprisen står fast til høyre.
Internasjonale målinger av modellene vi har testet, med leverandørenes listepriser til slutt. Høyeste verdi blant våre modeller er uthevet.
Høyere er bedre i alle målingene, og for listeprisene er lavere bedre. Varianten modellen ble målt med står under tallet, fordi kildene ofte måler et annet resonneringsnivå enn vi bruker selv («high»). Arena-poeng med få stemmer er usikre.
Sist oppdatert: Epoch AI 04.10.2026 · Arena 02.10.2026. Kilder: Epoch AI (CC BY 4.0, hentet 4. oktober 2026); Arena (LMArena) (CC BY 4.0, hentet 4. oktober 2026). Utvalgt og avrundet av oss.
Slik kan du lese det
Tabellen viser hvordan modellene står seg utenfor våre tre oppgaver. Arena bygger på brukerstemmer, og Epoch AI samler mange prøver med fasit i én indeks.
Målingene er gjort med andre oppgaver, på engelsk og ofte med et annet resonneringsnivå enn vi bruker. Bruk dem sammen med våre resultater, ikke i stedet for dem.
Brukere stiller samme spørsmål til to anonyme modeller og velger det beste svaret. Resultatet blir en rangering i Arena-poeng, beregnet med Bradley–Terry-modellen og med stilkontroll (svarlengde og formatering teller ikke med), slik Arena selv viser den.
Arena kode (WebDev)
Som over, men brukerne ber om nettsider og apper og vurderer det som bygges. Her finnes ingen variant med stilkontroll.
Arena agent
Brukerne vurderer modellen som agent i lengre arbeidsøkter med verktøy. Måles i økter, ikke stemmer.
Epoch Capabilities Index (ECI)
Epochs samleindeks. Den vekter mange benchmarks etter hvor vanskelige de er, så modeller kan sammenlignes selv om de ikke har tatt nøyaktig samme prøver.
Listepris
Leverandørens egen pris per million tokens inn og ut, lest på prissidene deres. Ikke en måling.
Modellene
Hvem vi tester, og hvor data behandles
Modellene kjøres gjennom leverandørenes egne API-er. Testene inneholder bare offentlig materiale og ingen opplysninger om studenter eller brukere av verktøyet. Tabellen viser hvor hver leverandør behandler det som sendes. Flere modeller legges til etter hvert som de er testet.
Modellene vi har testet, med leverandør, listepris og hvor data behandles
Modell
Leverandør
ListeprisUSD per 1M tokens, inn / ut
Hvor data behandles
Claude Fable 5.1
Anthropic
10 / 50
USA (Anthropic). Krever 30 dagers lagring hos leverandøren.
Claude Opus 5.5
Anthropic
4 / 20
USA (Anthropic).
Gemini 3.1 Pro (forhåndsversjon)
Google
2 / 12
Google (ingen EU-region i Developer API). Misbrukslogger i 55 dager. Betalt nøkkel kreves i EØS.
Mistral Medium 3.5
Mistral AI
1,65 / 8,25EU-endepunktet, 10 % dyrere
EU EU (Mistral AI, Frankrike), via EU-endepunktet.
Claude Sonnet 5.5
Anthropic
2 / 10
USA (Anthropic).
GPT-6.1 Sol
OpenAI
2 / 10
USA (OpenAI). Misbrukslogger i 30 dager. Ingenting lagres i API-et (store: false).
GPT-6 Sol
OpenAI
2 / 10
USA (OpenAI). Misbrukslogger i 30 dager. Ingenting lagres i API-et (store: false).
Gemini 3.8 Flash
Google
0,75 / 3,75introduksjonspris til 31.12.2026
Google (ingen EU-region i Developer API). Misbrukslogger i 55 dager. Betalt nøkkel kreves i EØS.
Sikkerhet
Slik holder vi testene adskilt
Modellene får ingen innlogging og ingen nøkler. Kallene til leverandørene og talegenereringen gjøres av kjøresystemet vårt utenfor modellens arbeidsmiljø. Leveransene vises fra lagringstjenestens egen adresse i en avgrenset ramme, ikke fra virtualaicorp.no, slik at koden modellene har skrevet aldri kjører side om side med innloggingen vår.
1Modellens beholderUten nett, uten innlogging og uten nøkler.
2Kjøresystemet vårtKaller leverandøren og talegenereringen på modellens vegne.
3Egen lagringsadresseLeveransen vises i en avgrenset ramme, ikke fra virtualaicorp.no.